Postmortem: Limitação de CPU pela Hostinger (2026-10-06)
A análise, as evidências e as ações estão completas. Falta a resposta do suporte da Hostinger sobre por que o limite foi acionado nesse momento específico. Ver O que a investigação fechou.
| Campo | Valor |
|---|---|
| Data do incidente | 2026-10-06 |
| Severidade | Indisponibilidade parcial: jogadores sem conseguir conectar durante parte do dia, além da lentidão |
| Status | Mitigado (serviço normalizado às 22:05); causa raiz entendida; e-mail enviado ao suporte da Hostinger em 2026-10-08, aguardando retorno |
| Serviços afetados | Servidor(es) de jogo na VPS Hostinger (srv503207.hstgr.cloud) |
| Detectado por | Jogadores reportando lentidão e falha de conexão ("servidor ta off") no Discord da equipe |
| Mitigado por | Ryuzaki |
| Investigação pós-incidente e escrita | Tsugami |
| Provedor | Hostinger (VPS) |
| Postura | Blameless: a análise mira o sistema e o processo. Nomes aparecem para reconstruir os fatos, não para atribuir culpa |
Resumo
Durante dez horas e meia, ninguém conseguiu jogar. Às 11:26:30 a Hostinger cortou a CPU da nossa VPS para 20%, automaticamente, sem aviso prévio e sem e-mail. A máquina continuou de pé e nada havia mudado na aplicação. Nosso monitoramento registrou o efeito no mesmo minuto e o alerta chegou ao canal certo, onde se perdeu no meio das dezenas de notificações que o #alerting já recebia todos os dias. Descobrimos às 21:14, quando um jogador perguntou no Discord se o servidor estava off.
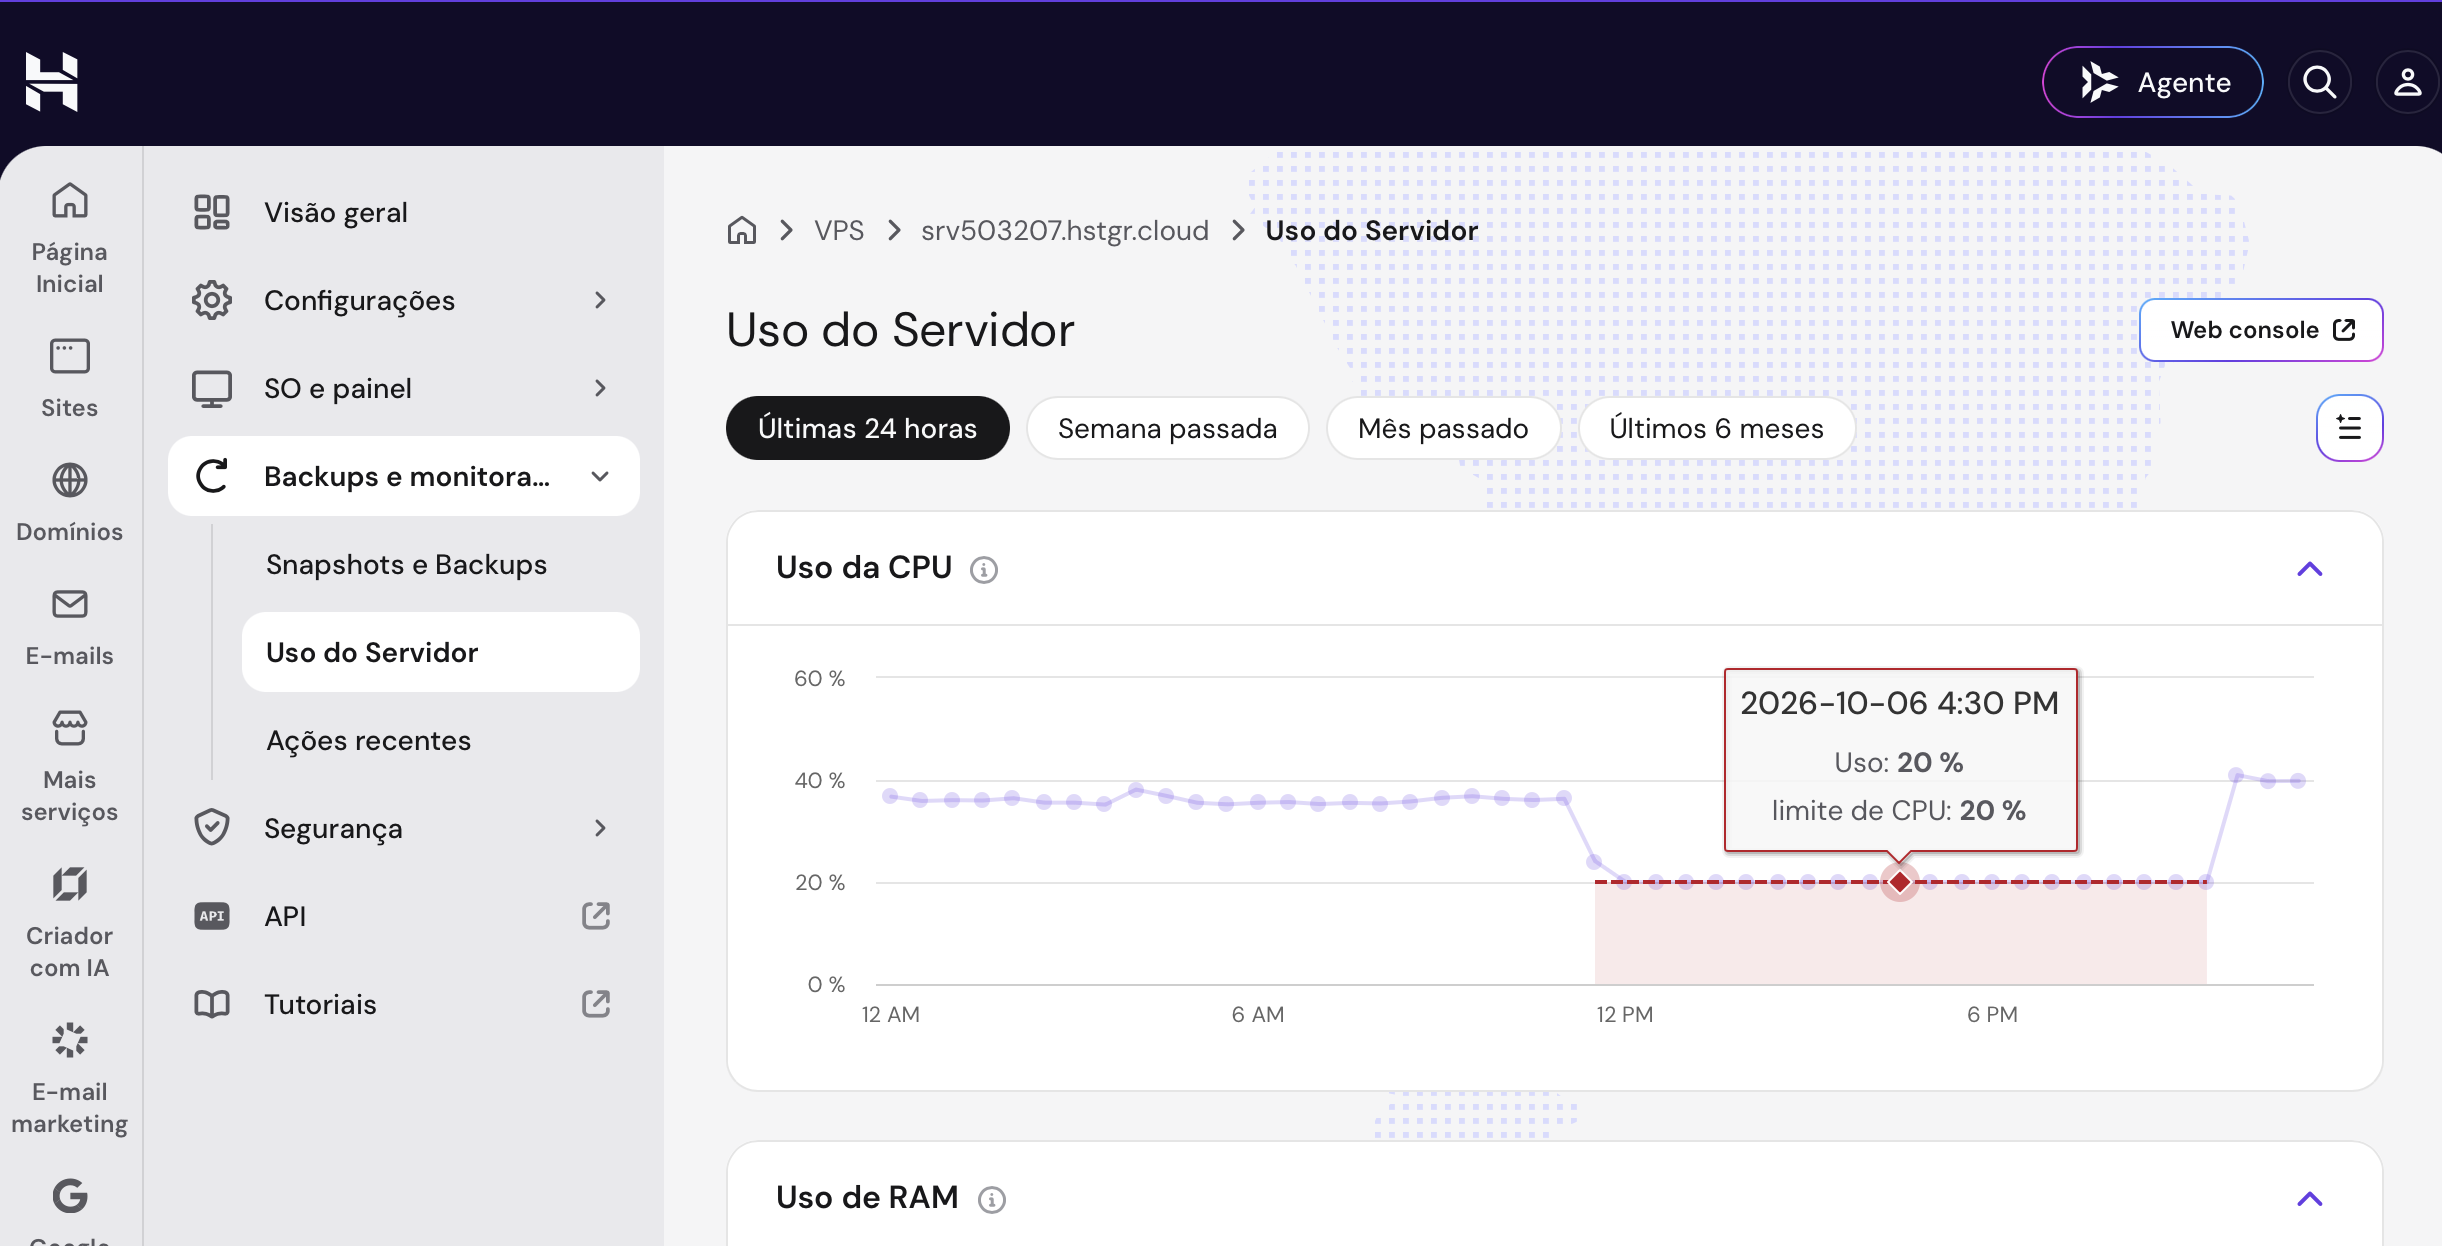
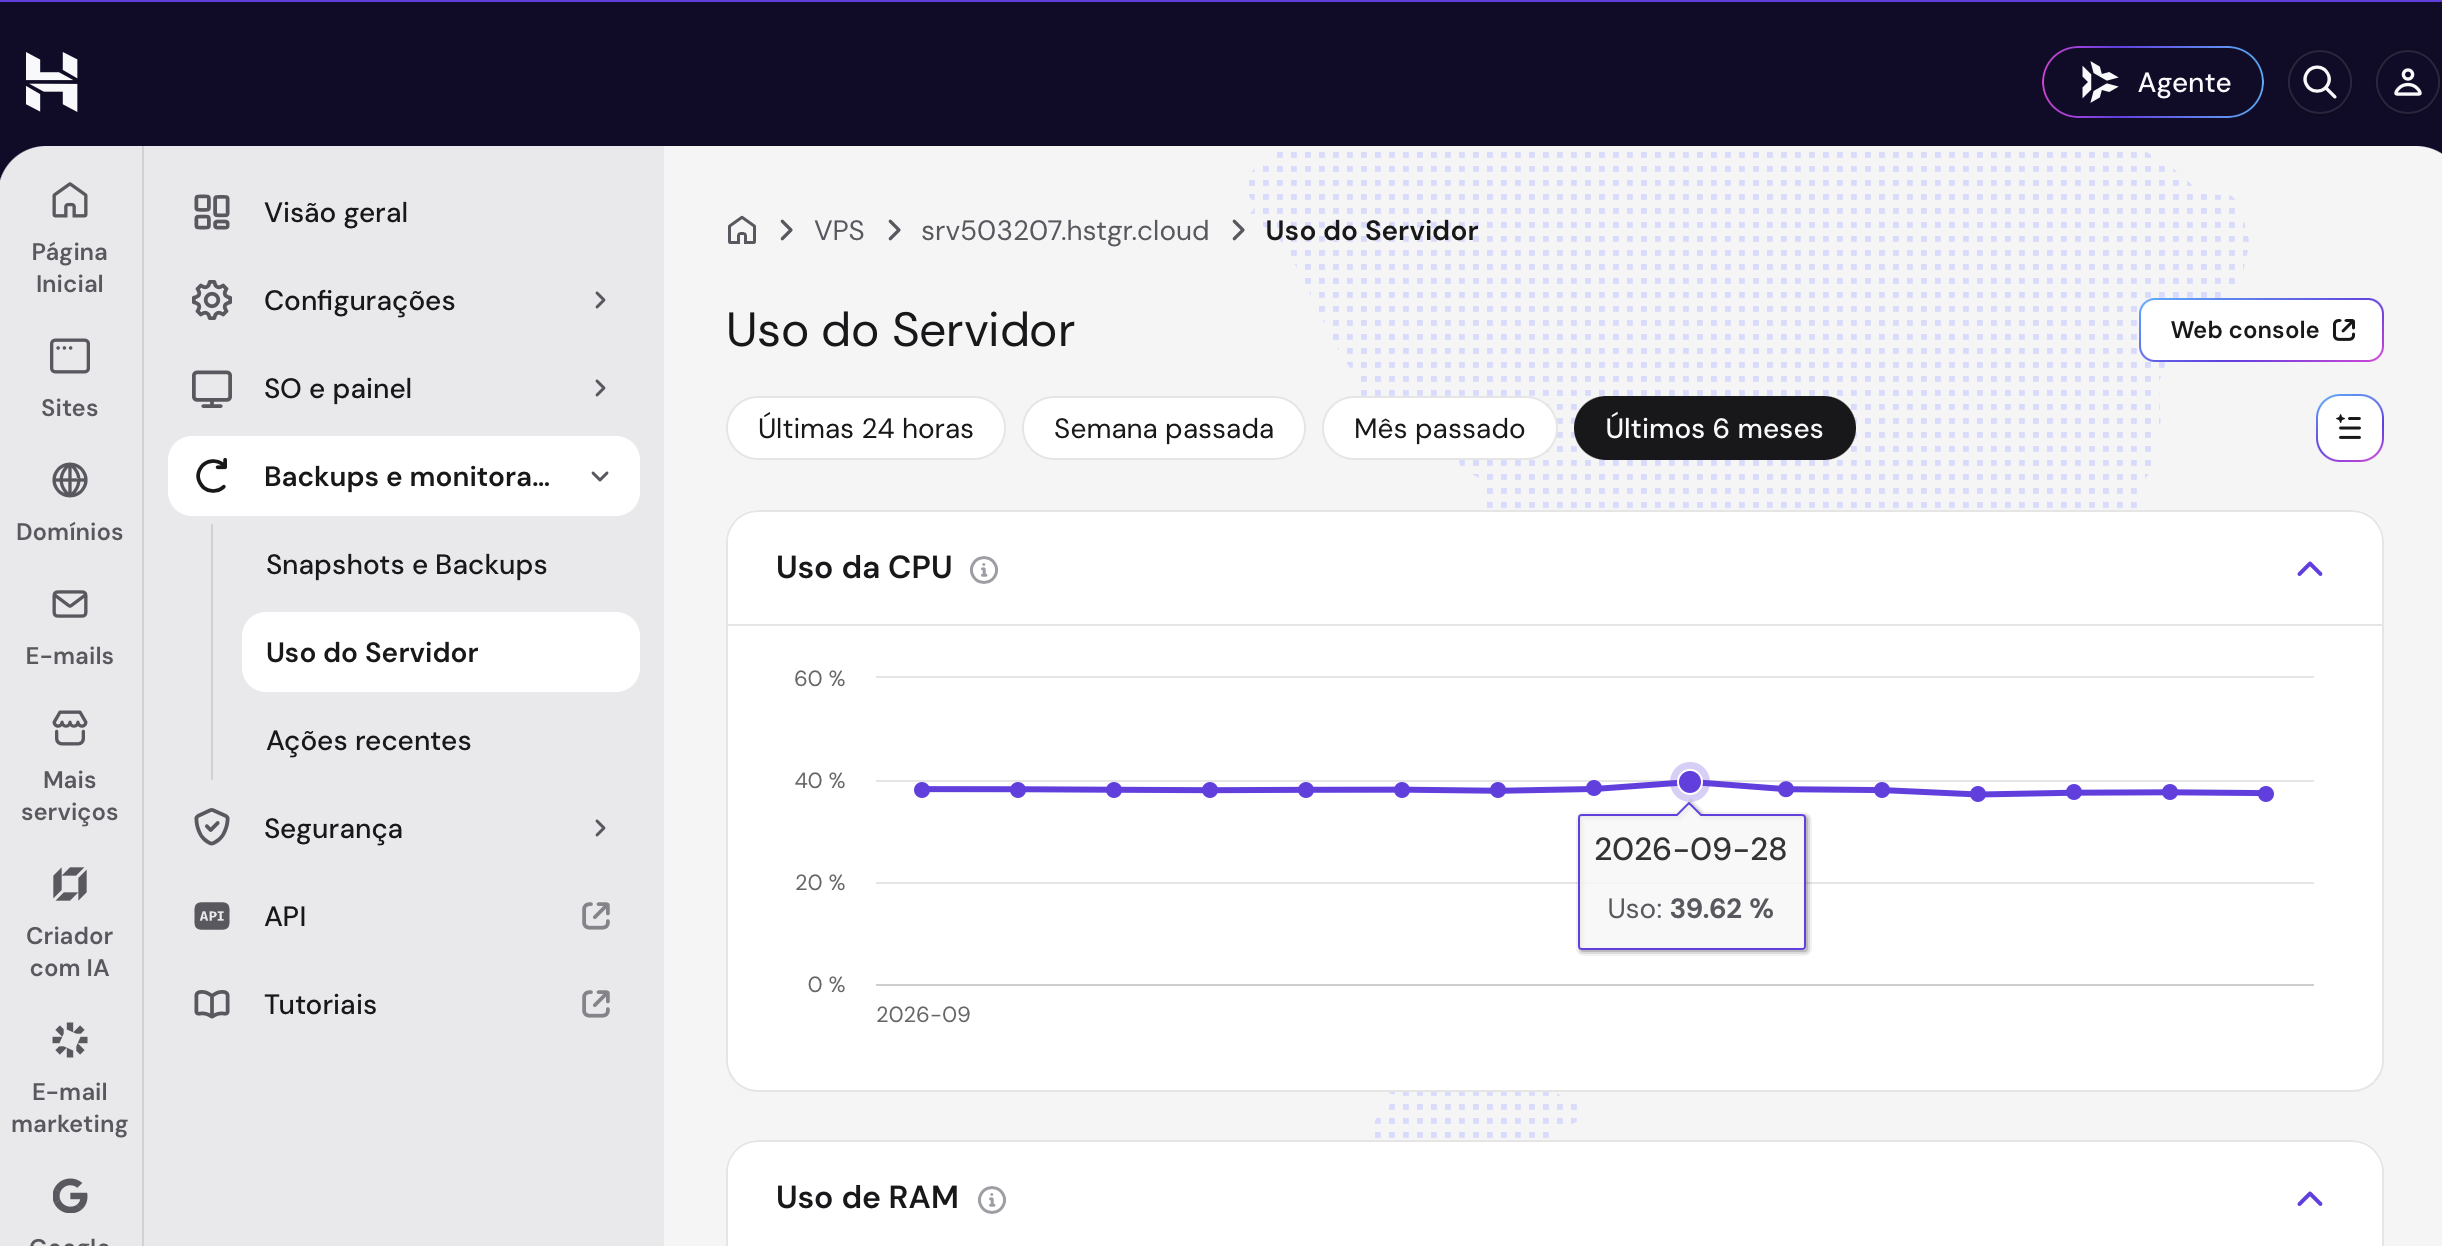
O limite não foi reação a um pico anômalo. A VPS sustentava ~37-40% de uso de CPU de forma contínua havia meses, e o dia 06/10 começou igual a qualquer outro: o painel da Hostinger mostra o mesmo patamar nos últimos 6 meses e na semana anterior, até a véspera. O que mudou às 11:26:30 foi a decisão do provedor. A nossa carga seguiu igual.
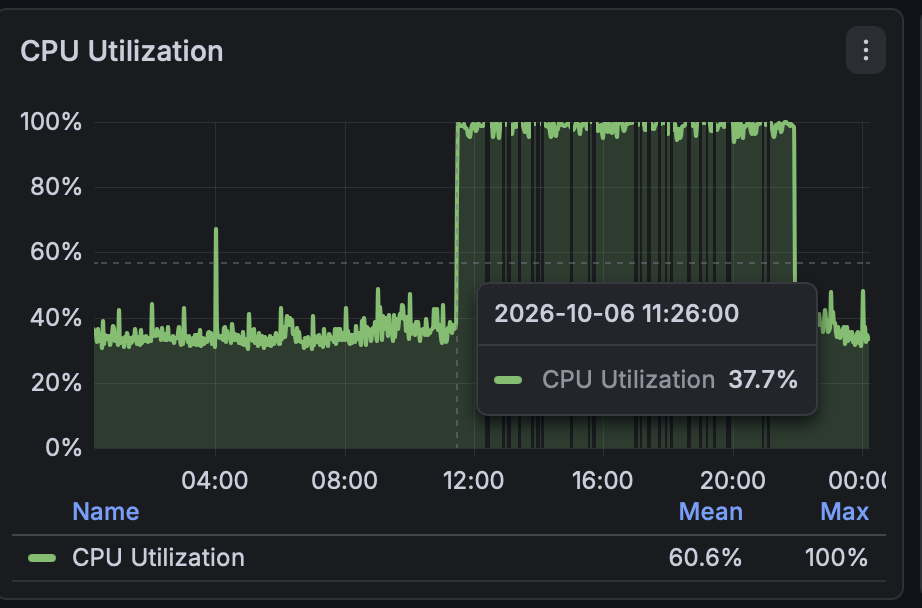
Com o teto de 20% em vigor, os processos continuaram pedindo a CPU de sempre e passaram a ser cortados repetidamente ao bater no novo limite (throttling). No nosso Grafana isso aparece como um dente de serra perto de 100% a partir de ~11:26:00. O gráfico parece denunciar um processo descontrolado, mas retrata o corte (ver Causa raiz).
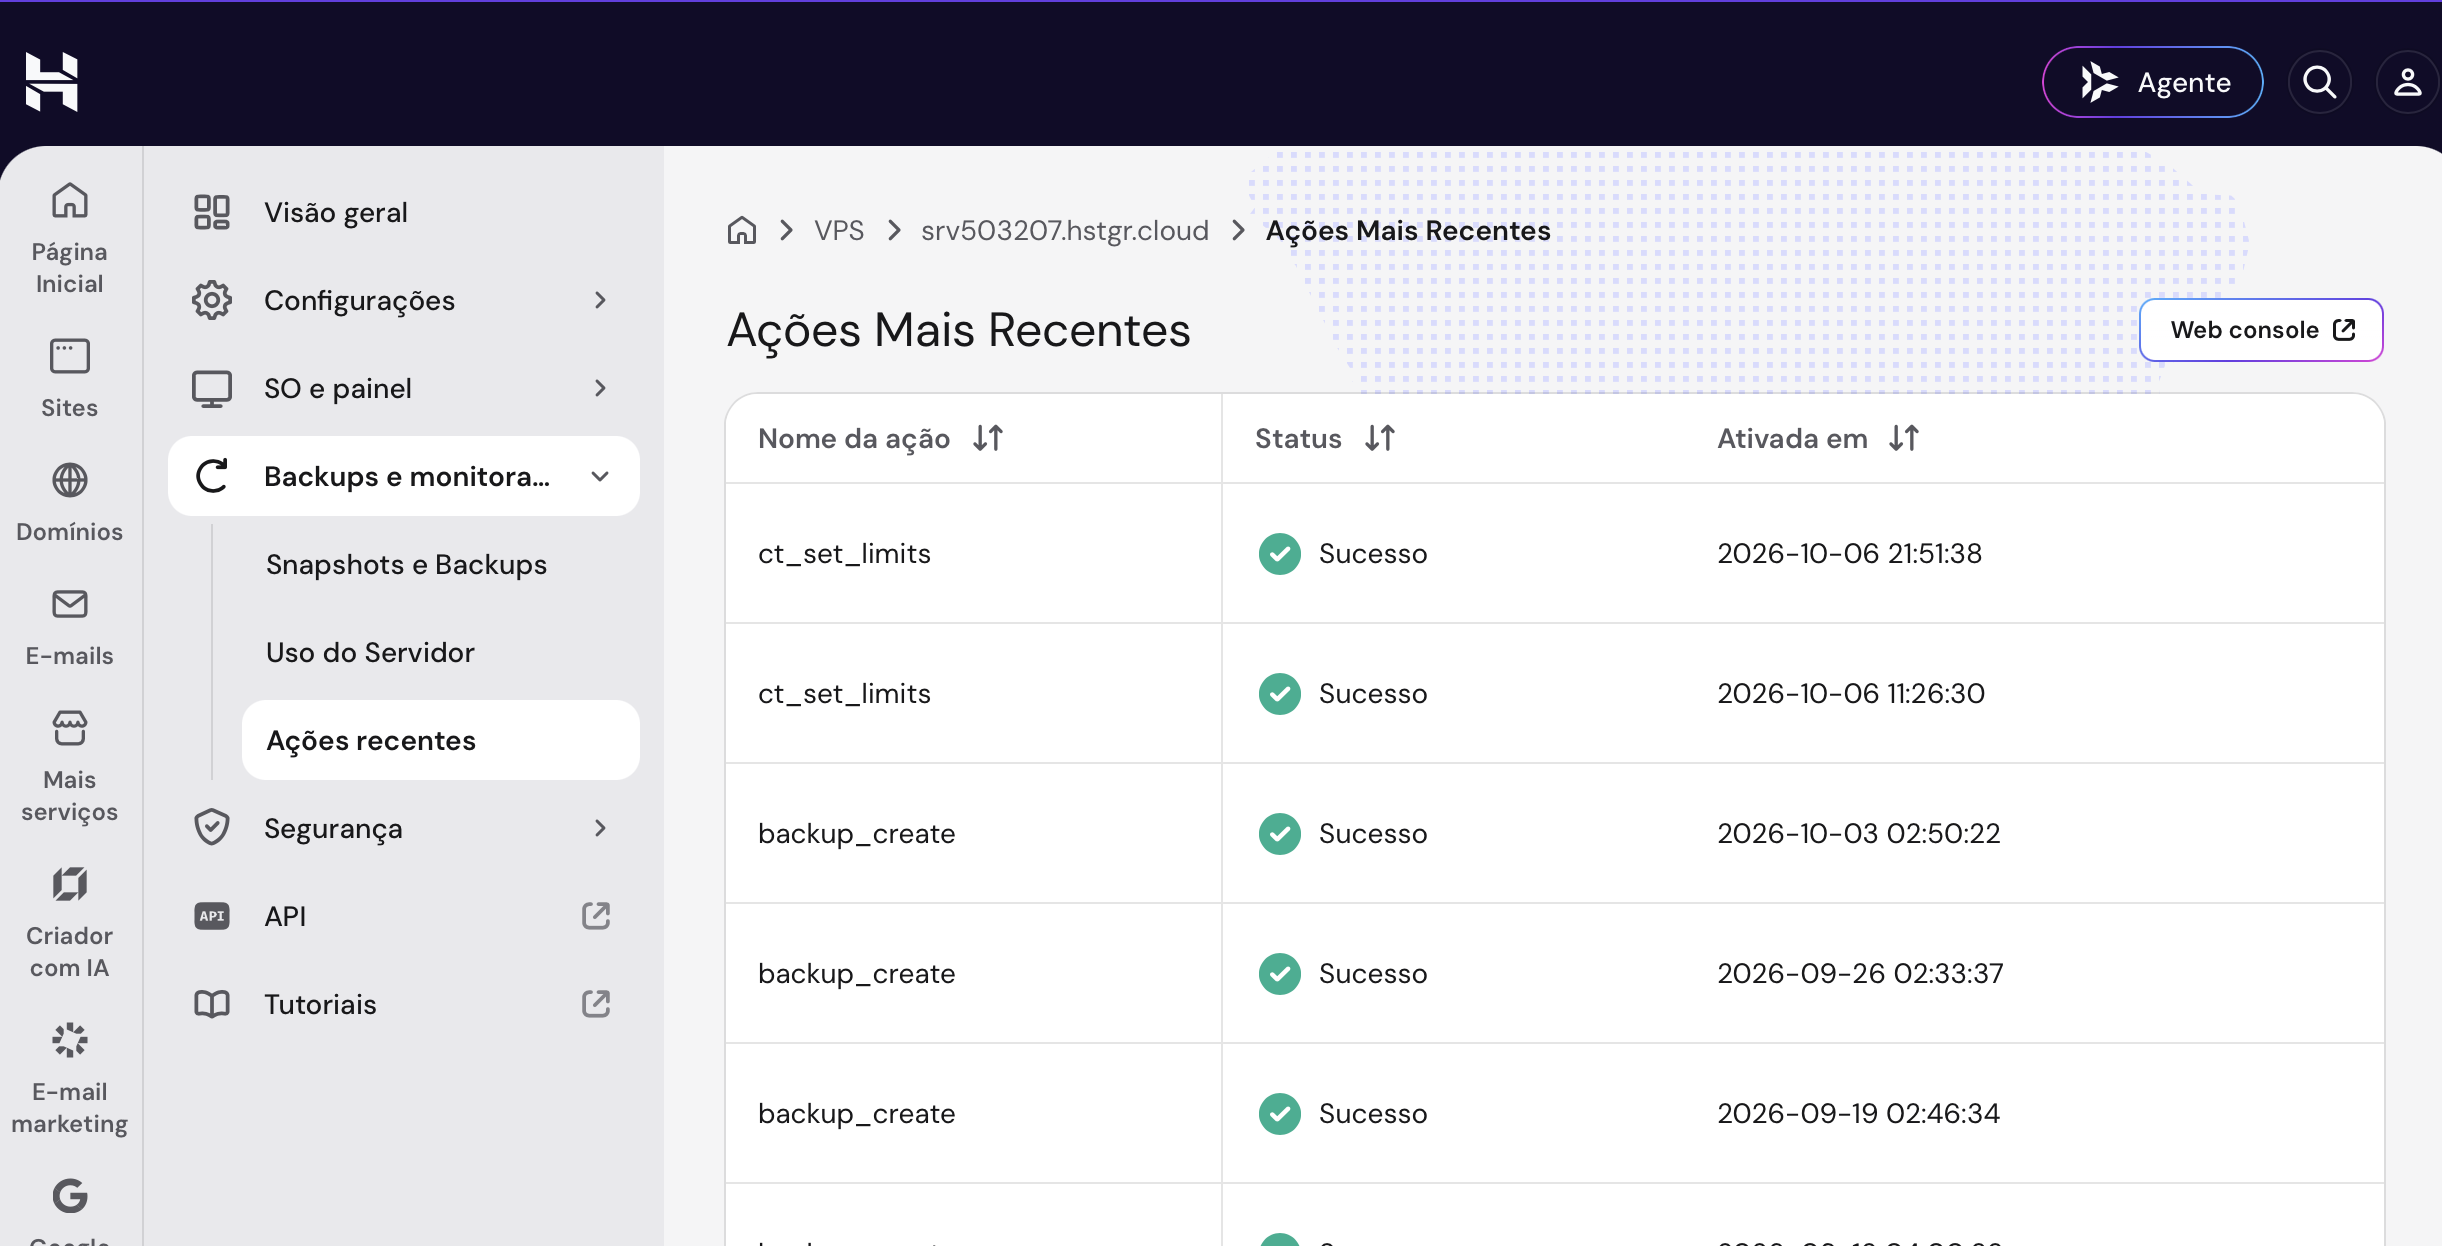
Nenhum dos dois eventos gerou notificação: nem a aplicação do limite, nem a remoção horas depois. A única informação do lado do provedor ficou no log de ações do console, que ninguém tem motivo para abrir em um dia comum.
A mitigação foi manual: às 21:51:38, Ryuzaki clicou em "Remover limite" no painel da Hostinger, 38 minutos depois do primeiro relato. O serviço foi confirmado normalizado às 22:05, com o uso de CPU de volta à faixa de ~37-40%.
Os gráficos e registros que sustentam cada afirmação acima estão reunidos em Evidência.
Linha do tempo
| Horário (2026-10-06) | Evento |
|---|---|
| Semanas/meses anteriores | CPU sustentada em ~37-40% de forma contínua (confirmado pelo gráfico de 6 meses/semana da Hostinger e pelo nosso Grafana). Canal #alerting do Discord já recebia alertas relacionados nesse período, ignorados por spam |
| 11:26:30 | Hostinger aplica a limitação de CPU automaticamente (console, sem e-mail) |
| ~11:26:00-11:26:30 | Nosso Grafana registra o uso de CPU saindo de ~37-40% e disparando para picos de ~100% em padrão de dente de serra: leitura do throttling causado pelo limite acima, com os 30s de diferença explicados por defasagem de coleta/clock entre os dois sistemas |
| ~12:00 | Gráfico "Uso do Servidor" (últimas 24h) do painel da Hostinger passa a mostrar um teto achatado de 20% |
| ⏳ 9h48 de silêncio | O #alerting recebe de 40 a 70 notificações por hora, e ninguém olha. Jogadores tentam entrar, não conseguem, e assumem que o problema é na própria máquina. Nenhum sinal chega à equipe |
| ~20:00 | Jogador (Nighty) relata, retroativamente, que já tentava entrar no servidor desde então; primeira tentativa sem sucesso por volta das 20h |
| 21:14 | Jogador (PS2slim) reporta no Discord da equipe (#chat-frontier): "servidor ta off? tentei entrar aqui não foi" |
| 21:18 | Kushi (equipe ARCA) responde: "vou olhar" |
| 21:37 | Nighty confirma que também está sem conseguir entrar desde as 20h |
| 21:51:38 | Ryuzaki clica em "Remover limite" no painel da Hostinger: mitigação manual, registrada no log de ações do console |
| 21:52 | Nighty relata que vinha tentando desde as 20h, mas achava que era um problema isolado na própria máquina; só percebeu que era geral ao ver o relato de PS2slim |
| 22:05 | Kushi confirma no Discord que o servidor voltou ao normal |
| Após 21:51:38 | Uso de CPU volta à faixa de ~37-40% (confirmado tanto pelo painel da Hostinger quanto pelo nosso Grafana) |
O que esses horários somam
- 10h38 de impacto, das 11:26:30 às 22:05.
- 9h48 até a detecção. Nenhum sinal automático chegou a alguém: o aviso veio de um jogador perguntando no Discord se o servidor estava off.
- 38 minutos da detecção à mitigação, incluindo diagnosticar um comportamento do provedor que a equipe nunca tinha visto antes.
A detecção custou quinze vezes mais que a correção.
Evidência
O gráfico de uso de CPU das últimas 24h, com o teto de 20% aplicado, está no Resumo.
Log de ações do console Hostinger. Os dois eventos ct_set_limits do dia: a aplicação automática às 11:26:30 e a remoção manual às 21:51:38. É o único registro textual do lado do provedor, e nenhum dos dois gerou e-mail:
Nosso Grafana, CPU Utilization. O efeito do limite no mesmo instante (~11:26:00, com a pequena defasagem de coleta entre os dois sistemas): o uso sai de ~37,7% e passa a oscilar em dente de serra perto de 100%, à medida que os processos batem no novo teto e são cortados:
Uso de CPU, últimos 6 meses. Padrão sustentado de ~37-40%, bem antes do incidente:
Uso de CPU, semana passada. Mesmo padrão de ~37-40%, mantido até a véspera do incidente:
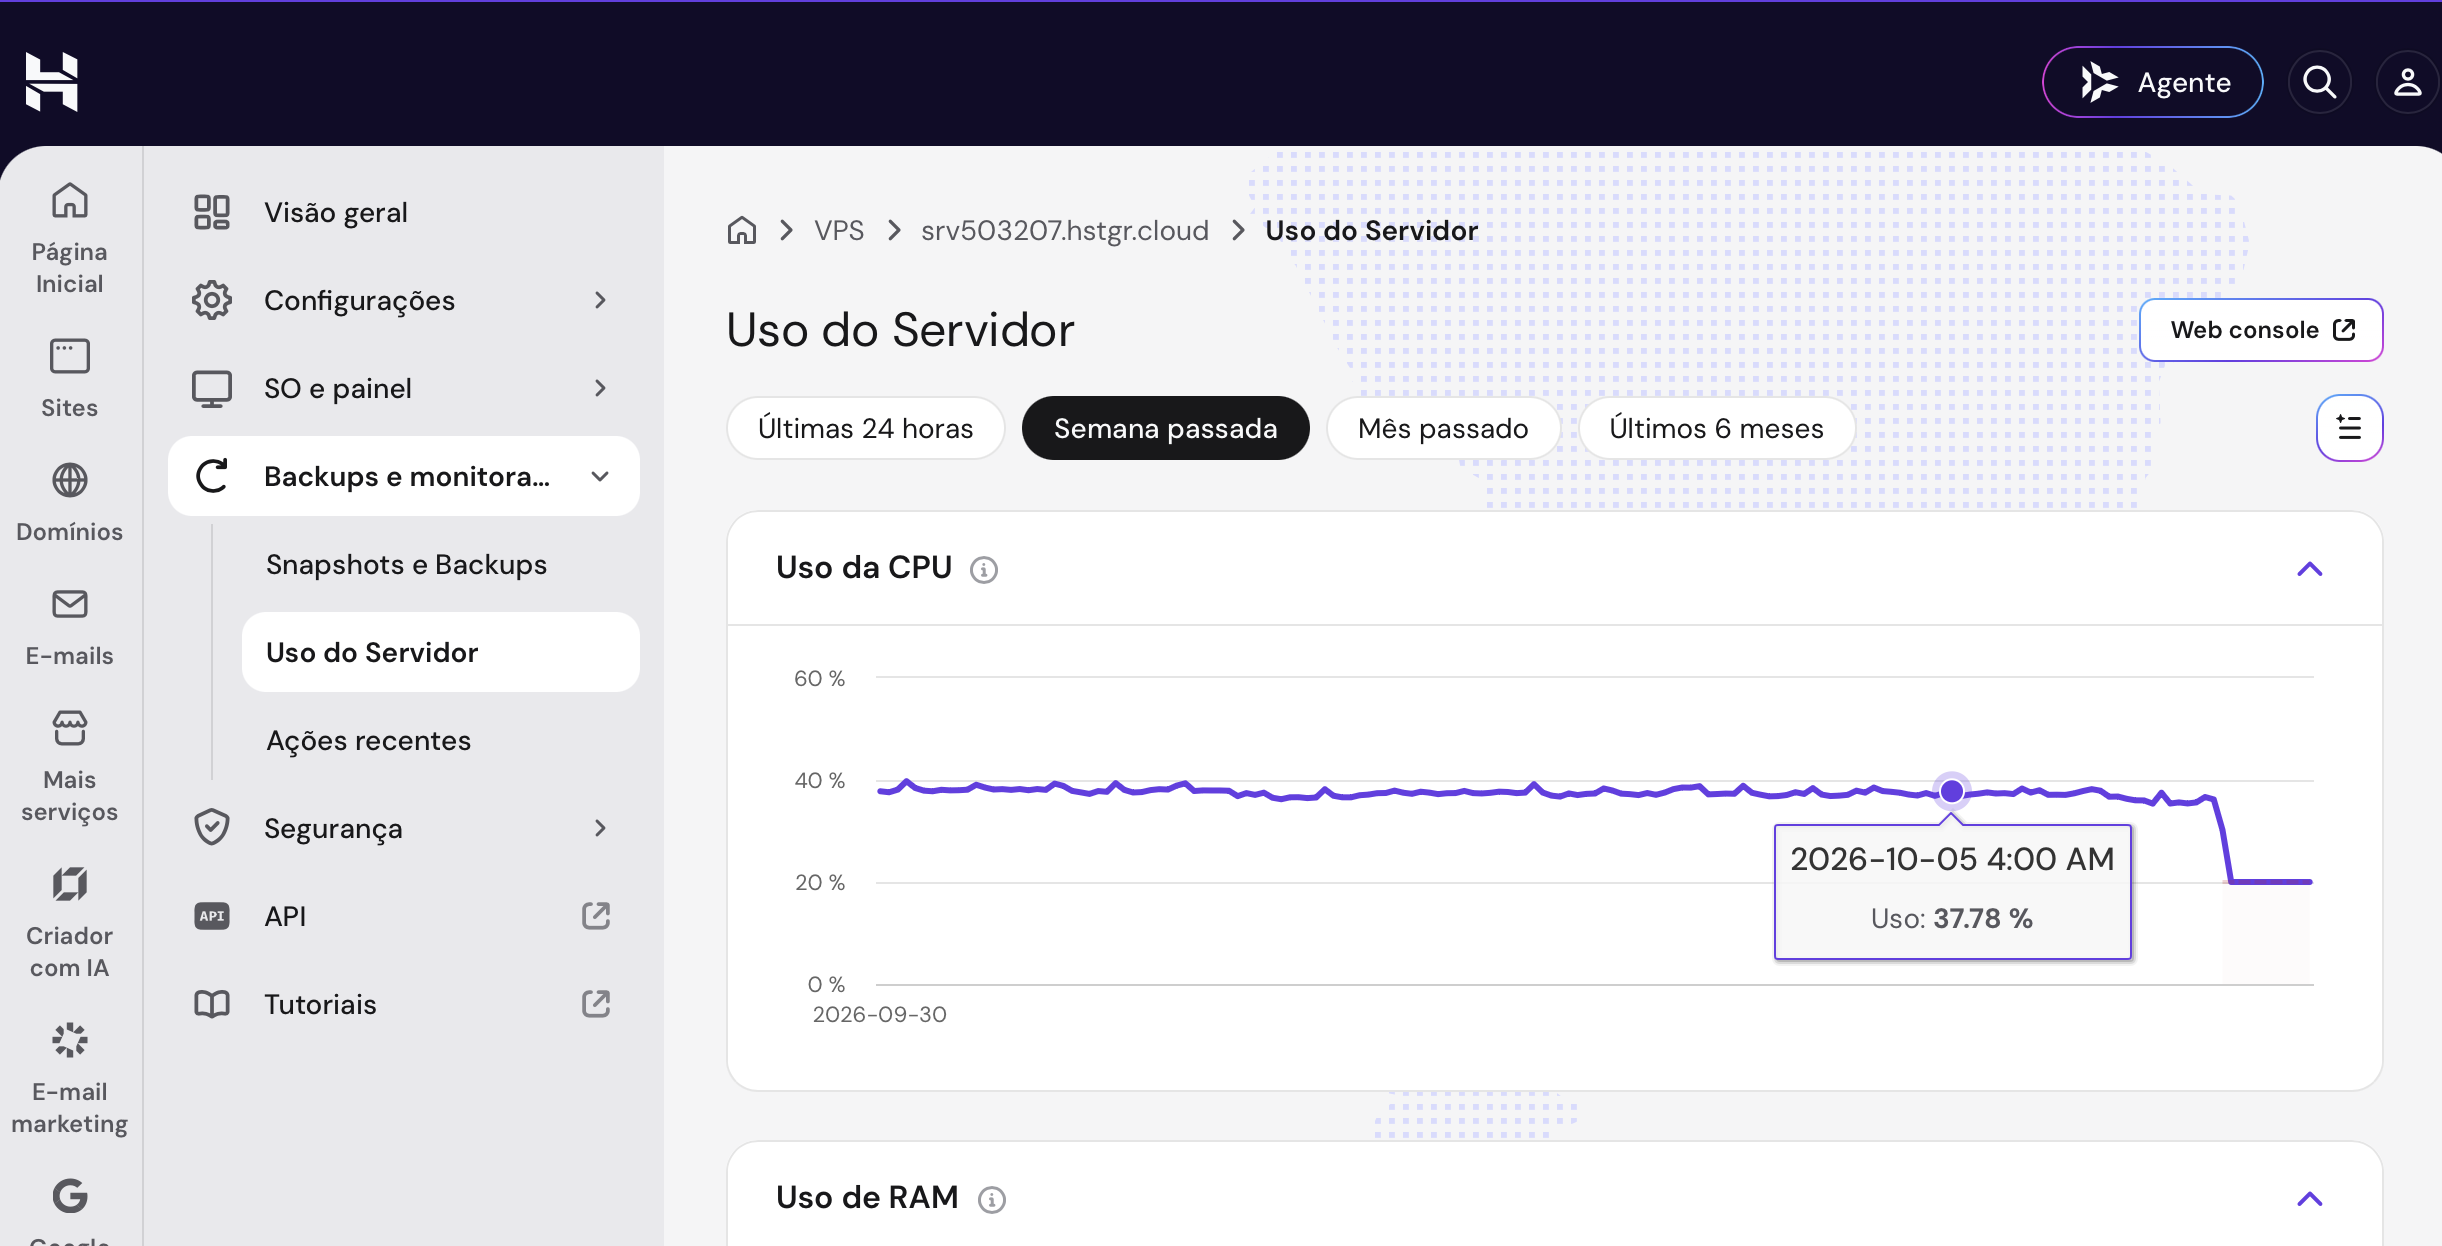
Relato dos jogadores no Discord da equipe (#chat-frontier). Confirma a indisponibilidade percebida e a resolução:
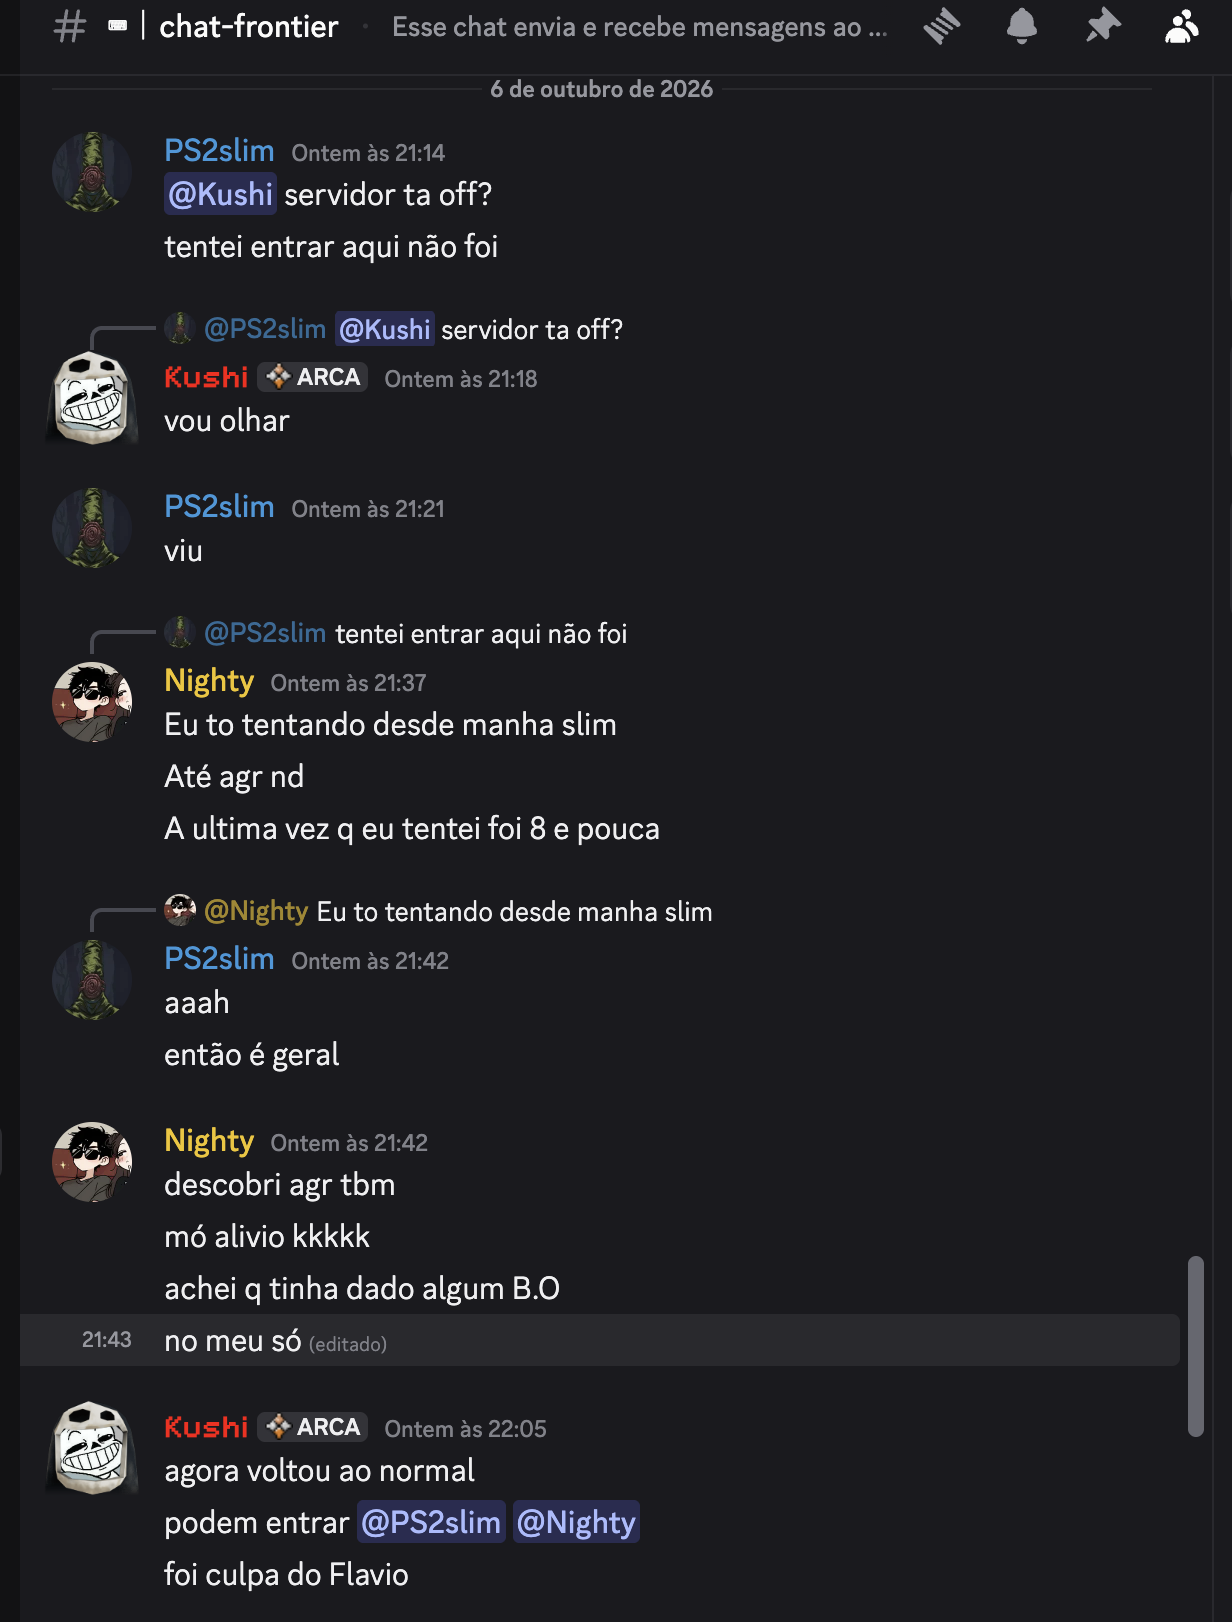
IDs do Discord dos jogadores citados (para referência, caso o nome de exibição mude no futuro): Nighty → 803328019641008168, PS2slim → 471506237536600075.
Mitigação
A ação que resolveu o incidente foi manual: Ryuzaki acessou o painel da Hostinger e clicou em "Remover limite" na VPS, às 21:51:38, também registrada no log de ações do console (a remoção do limite gera o mesmo tipo de registro que a aplicação, ver Evidência). O serviço foi confirmado normalizado pela equipe no Discord às 22:05, e tanto o painel da Hostinger quanto o nosso Grafana mostram o uso de CPU retornando à faixa de ~37-40% a partir desse ponto.
A ação resolveu o sintoma (o limite imposto pela Hostinger), mas a condição de fundo continua a mesma: a VPS segue com o uso-base de ~37-40% que já era estável havia meses. Nada na aplicação mudou: se a Hostinger aplicar o mesmo critério novamente no futuro, o corte pode se repetir, mesmo sem nenhuma falha nova do lado da ARCA.
O painel da Hostinger é acessível por Yslan Ramos e Ryuzaki. Se o corte voltar, são as duas pessoas capazes de remover o limite.
Impacto
- Jogadores relataram lentidão e falha de conexão no servidor durante o período afetado. Pelo menos dois (
PS2slim,Nighty) relataram não conseguir entrar ("servidor ta off", "tentei entrar aqui não foi"), com tentativas frustradas desde ~20:00 até a confirmação de retorno às 22:05. Nightysó reportou à equipe entre 21:37 e 21:52, mesmo tentando entrar desde as 20h, porque achava que o problema era isolado na própria máquina. Isso também atrasou a percepção de que era um incidente geral.- O problema foi percebido como geral pelos próprios jogadores ("então é geral"), não isolado a um único usuário ou conexão.
- Resolvido por volta de 22:05, quando a equipe confirmou no Discord que o servidor voltou ao normal, cerca de 13 minutos após a remoção manual do limite (21:51:38).
- Impacto em negócio (churn, reclamações fora do Discord, etc.) ainda não quantificado.
Evidência: CPU/memória por app (11:25-11:33)
As métricas por app do cluster k3s (via OTel, ver ADR 0001) na mesma janela mostram o efeito secundário do corte: com menos CPU real disponível na VPS, os apps passam a competir pelo pouco que sobrou, o que aparece como picos de uso em vários deles ao mesmo tempo. Não é que cada um tenha quebrado individualmente; o total disponível ficou menor.
Uso percentual (relativo ao limite configurado de cada app):
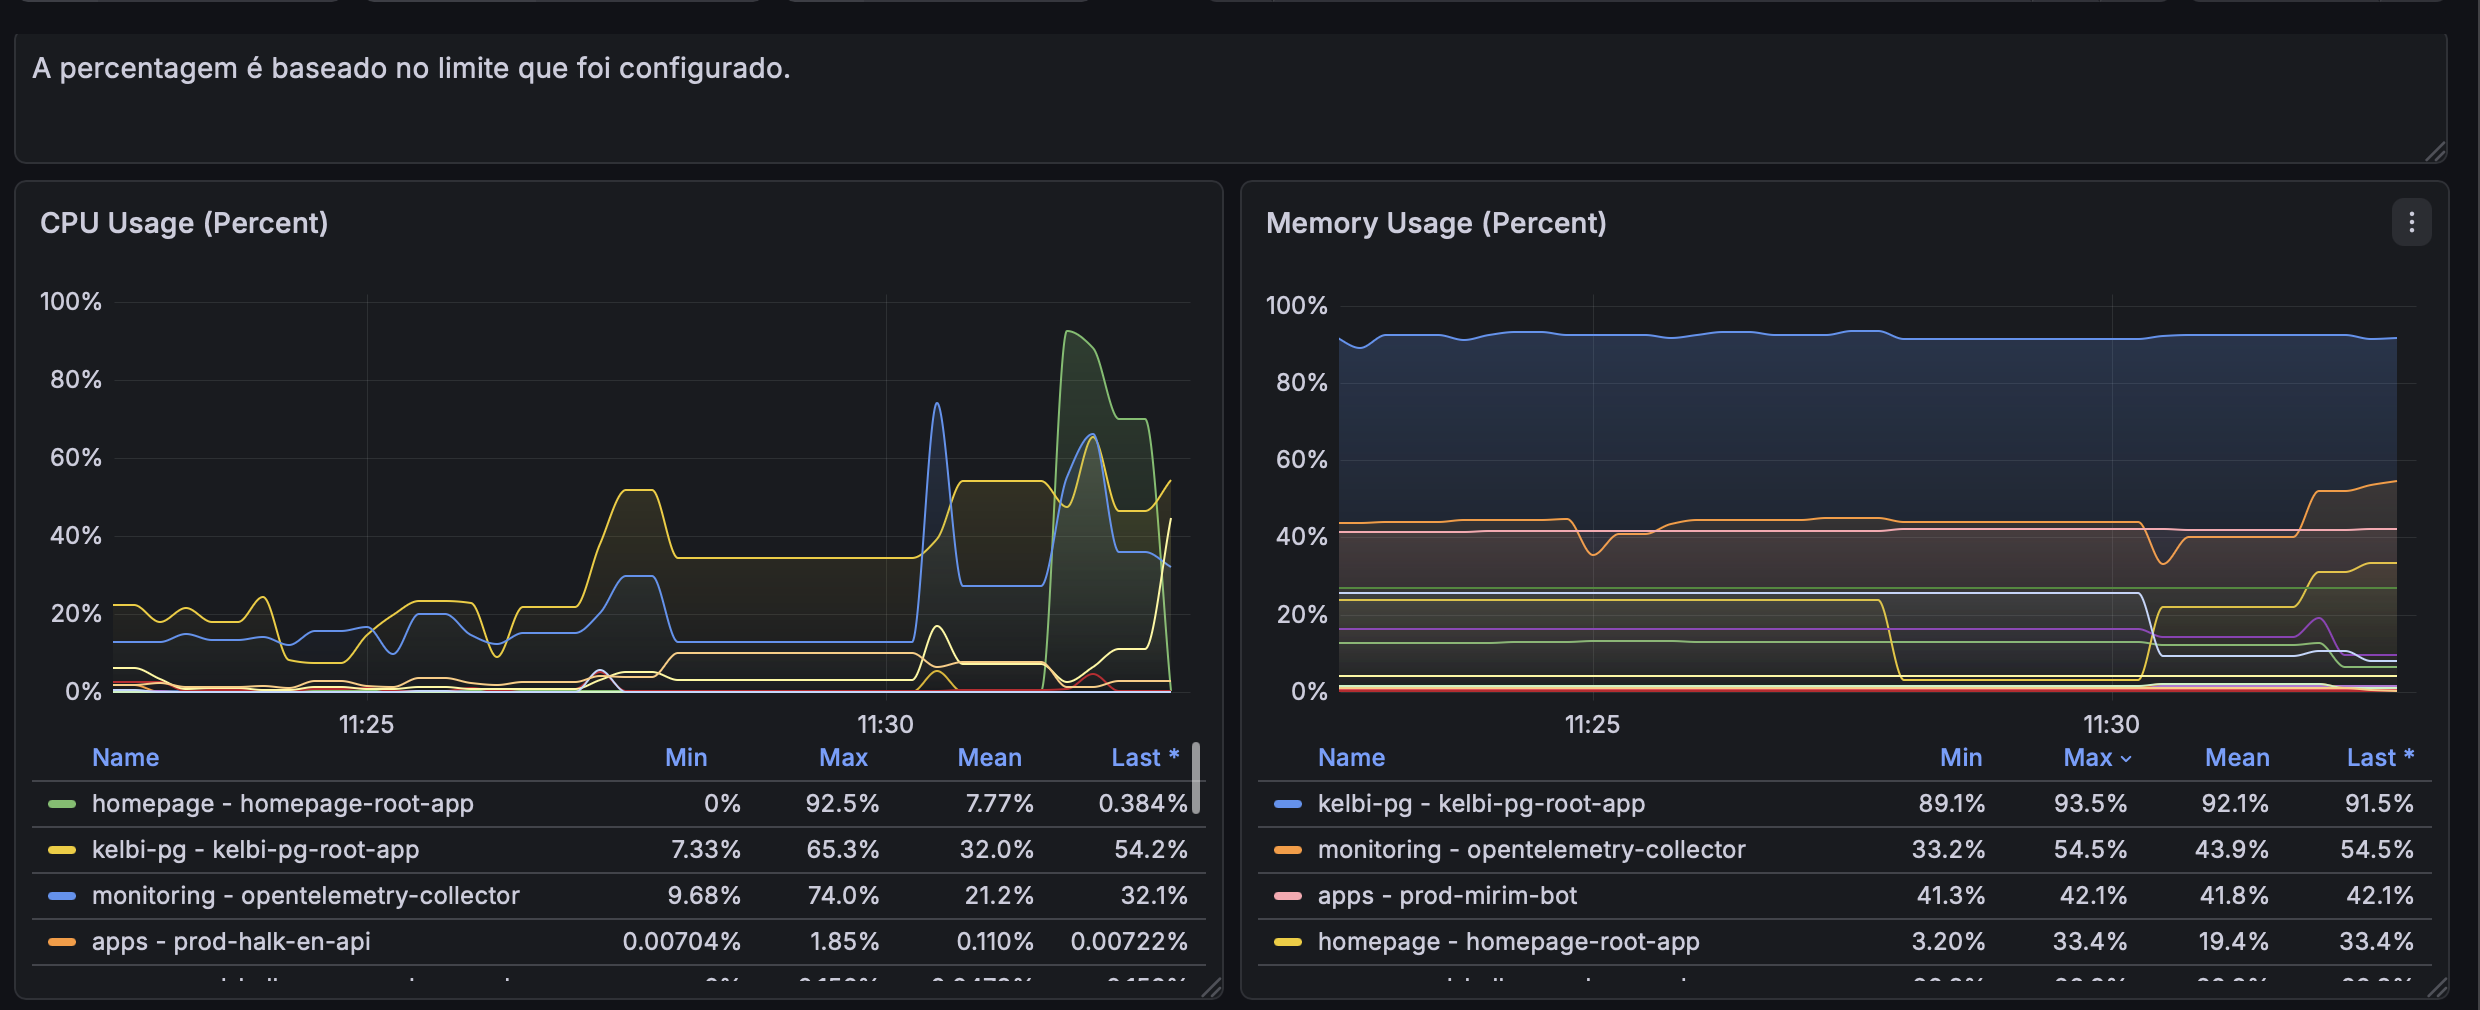
Uso absoluto (cores e bytes):
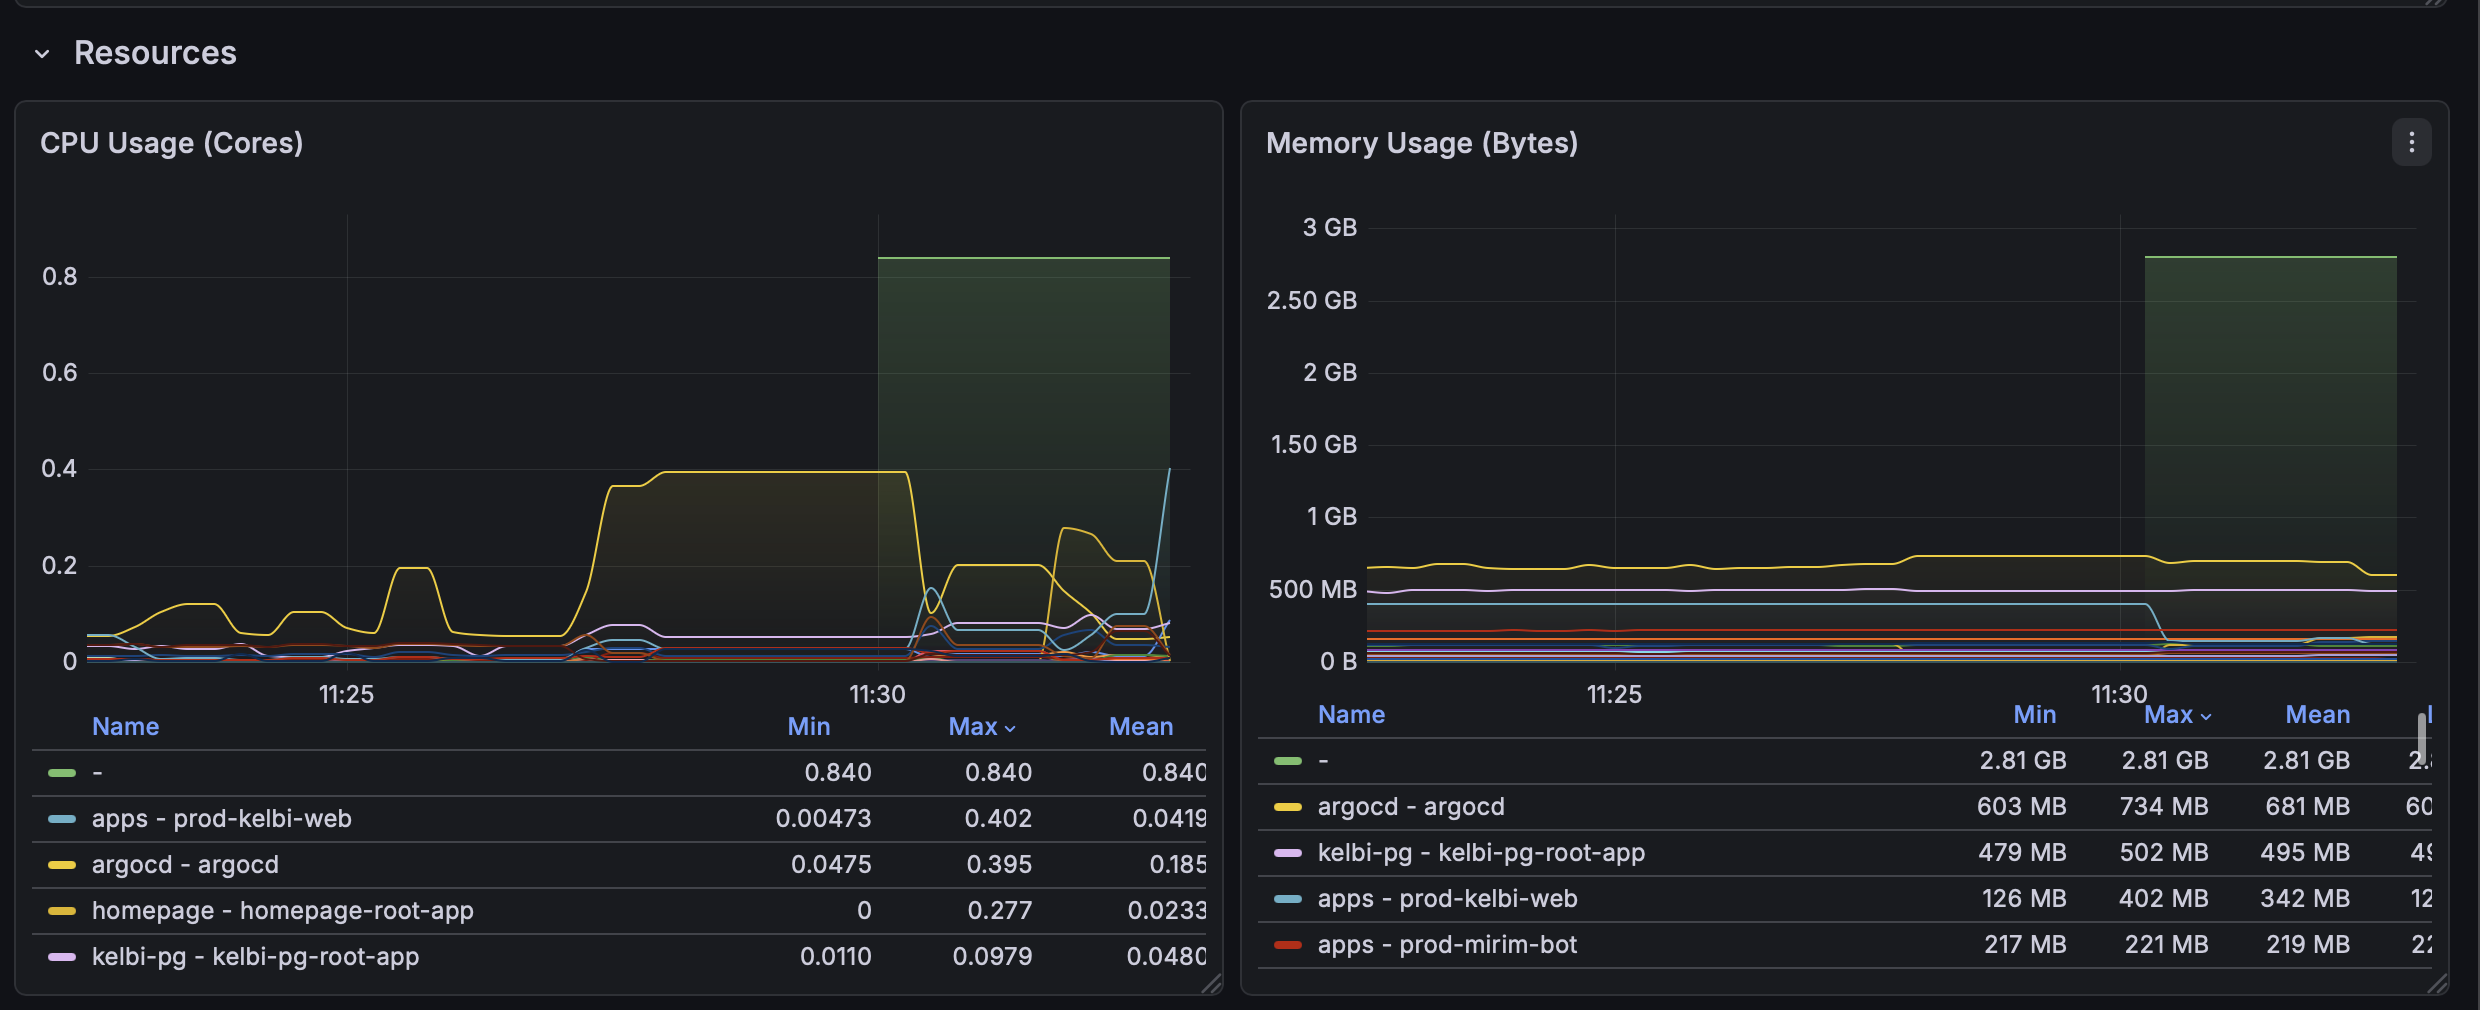
Dessas evidências:
homepage - homepage-root-appemonitoring - opentelemetry-collectorsobem para 92,5% e 74% dos respectivos limites configurados, consistente com contenção de recursos sob o novo teto, não com uma falha isolada em cada um.- A série sem nome (
-), com 0,84 cores / 2,81 GB, é uma cópia duplicada do cluster inteiro, criada por uma falha da própria coleta durante o incidente. Não é um app, nem a capacidade da VPS sob o limite. Ver abaixo.
A contagem dupla por trás da série sem nome
Durante o incidente, k8s_pod_cpu_usage tinha 130 séries para 65 pods distintos, ou seja, cada pod reportado duas vezes:
| Cópia | service.name presente? | Label job | Soma às 11:30 |
|---|---|---|---|
| Enriquecida | sim | namespace/app | 0,59 cores |
| Crua | não | ausente | 0,84 cores |
A recording rule que alimenta o painel por app deriva namespace e app a partir do job, via label_replace. Sem job, os dois labels saem vazios e o sum by (namespace, app) despeja a cópia crua inteira num único balde anônimo, que é o - do gráfico.
Consultando o Prometheus: 65 k8s_pod_uid distintos no grupo com job, e os mesmos 65 no grupo sem job. A soma das duas cópias dá 1,43 cores, mais que o triplo das 0,4 cores que a VPS tinha disponível sob o limite. Como esse valor é impossível, a contagem é dupla.
A cópia crua só existe em 06/10, de forma intermitente, entre 11:30 e 20:30, que é a janela de throttling. Não aparece em 05/10 nem depois da mitigação.
A leitura mais provável é que, sob inanição de CPU, o enriquecimento de metadados do OTel Collector passou a falhar de forma intermitente: às vezes a consulta de atributos do pod completava, às vezes não, e as séries não enriquecidas chegavam ao Prometheus sem service.name.
Durante as dez horas em que o painel por app mais importava, ele mostrava como maior consumidor do cluster um item sem nome, e escondia dentro dele a leitura real de todos os apps.
Causa raiz
Este incidente tem um gatilho externo e uma causa raiz interna. Vale separar os dois: tratados como a mesma coisa, todas as ações de melhoria acabam apontando para o fornecedor e nenhuma para nós.
Gatilho
Às 11:26:30, o algoritmo automático da Hostinger aplicou um teto de CPU na VPS, registrado como ct_set_limits no log de ações do console (ver Evidência). Não houve aviso prévio, e-mail ou justificativa, nem na aplicação nem na remoção horas depois. A única informação textual do lado do provedor é esse log.
O gatilho não foi reação a um pico anômalo de uso nosso. O uso-base de ~37-40% já era estável havia meses, e nada mudou do nosso lado em 06/10. Por que o algoritmo decidiu agir nesse momento específico, e não em qualquer outro dia com o mesmo padrão, continua desconhecido. Só o suporte pode responder, e é o que fomos perguntar.
Mecanismo: por que o gráfico engana
O pico de CPU de ~100% visto no Grafana a partir das 11:26:00 é o efeito visual do limite entrando em vigor, não uma causa separada. Com o teto aplicado, os processos da VPS continuam demandando a CPU que usavam antes (~37-40%) e passam a ser cortados (throttled) repetidamente ao bater no novo limite. É esse corte repetido que aparece como dente de serra nos minutos seguintes, não um processo descontrolado consumindo CPU à toa.
Não há, portanto, um processo "culpado" a ser caçado. A pergunta "o que causou o pico de CPU às 11:26:00" parte de uma premissa equivocada: o pico é consequência do limite, não sua causa.
Os 30s entre o início do pico no Grafana (11:26:00) e o registro do ct_set_limits no log da Hostinger (11:26:30) são defasagem de coleta/clock entre os dois sistemas (intervalo de scrape do Grafana vs. timestamp do log do console), não uma inversão real de causa e efeito: o limite é aplicado primeiro, o pico é a leitura do throttling resultante.
Como o limite foi imposto: CPU steal
CPU steal mede o tempo em que a VM queria usar CPU e não recebeu, porque o hipervisor não a escalonou. É uma métrica de uma camada acima das demais: o nosso Grafana mede o uso dentro da VM, enquanto o steal mede o que a VM pediu e o host negou.
Essa pista apareceu primeiro pelo suporte da Hostinger, que em 2026-10-08 fez uma checagem pontual do servidor e relatou 14,3% de CPU steal. Na época, sem dado histórico, isso abriu a hipótese de que uma mudança de contenção no host físico (um vizinho ruidoso) pudesse ter sido o gatilho da limitação.
O dado histórico existia. O scraper cpu do hostmetrics (ADR 0001) coleta system.cpu.time por estado desde março, steal incluído, e cobre a janela do incidente:
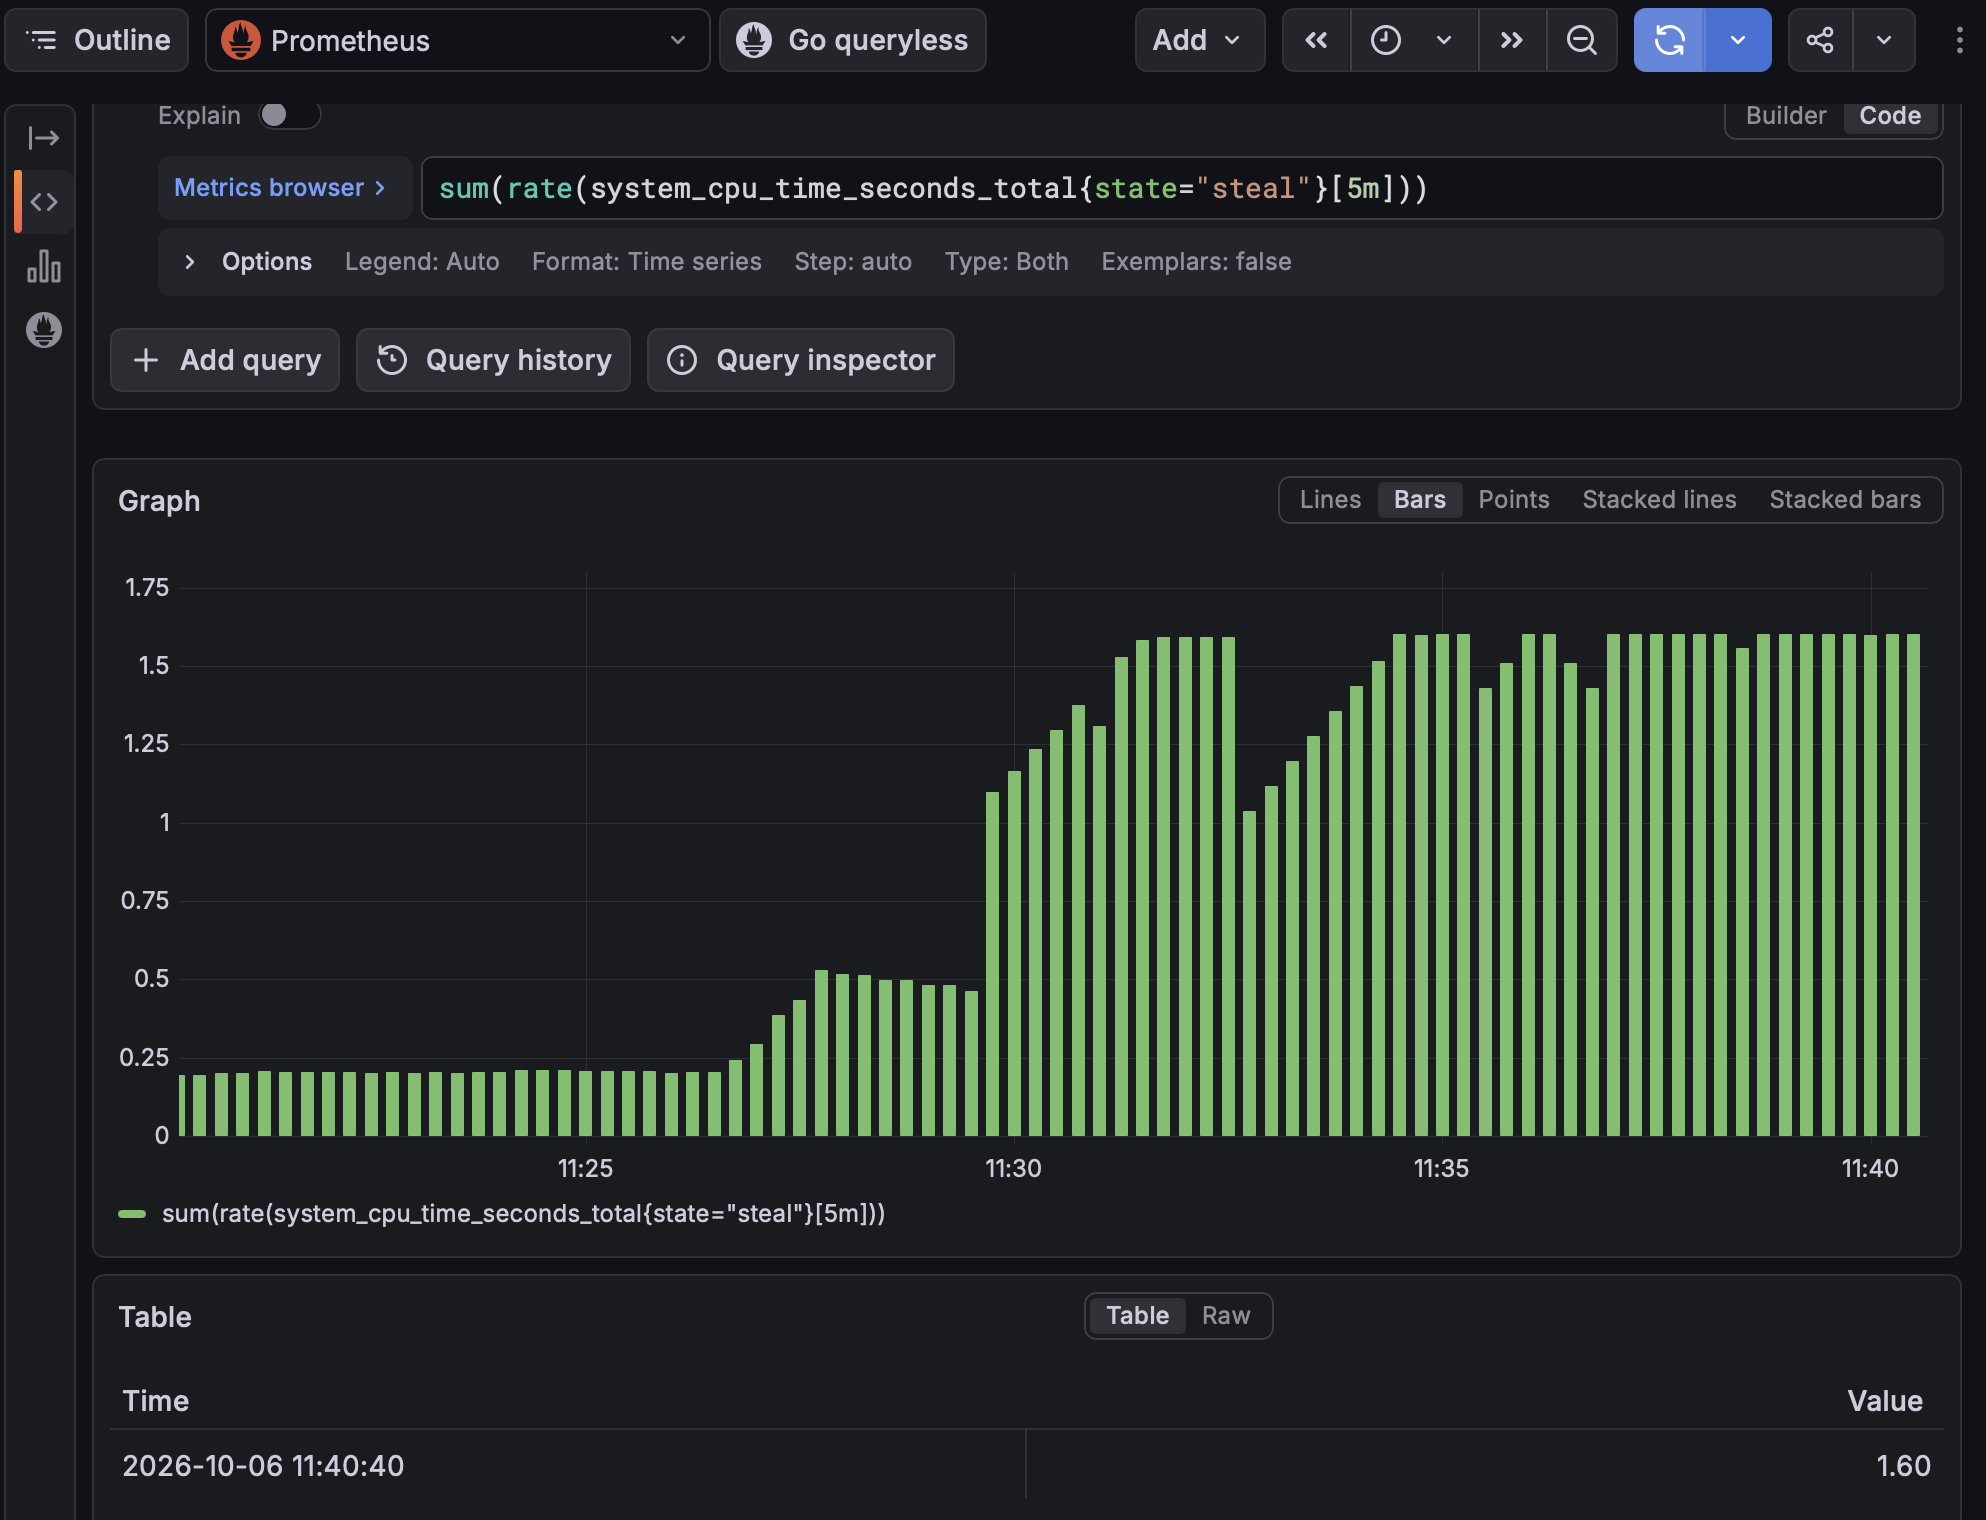
A leitura, em cores de CPU:
- Antes do corte, o steal fica estável. A média das 24h de um dia normal é de 0,247 cores, ou 12,4% das 2 vCPUs: é o ruído de fundo de um host compartilhado.
- A partir de 11:26 sobe e, por volta de 11:30, estabiliza em ~1,6 cores.
A aritmética fecha com o painel do provedor. A VPS tem 2 vCPUs; se 1,6 estão sendo retidas pelo hipervisor, sobram 0,4 cores, exatamente os 20% que o painel mostrava como "limite de CPU".
O trabalho real medido dentro da VM confirma pela terceira via. Consultando system_cpu_time_seconds_total com granularidade de 5 minutos na janela do corte:
| Horário (BRT) | Trabalho real do nó |
|---|---|
| 09:30 às 11:25 | 0,58 a 0,62 cores, plano |
| 11:30 | 0,478 cores |
| 11:35 em diante | 0,407 a 0,412 cores |
Três medições independentes chegam ao mesmo teto: o painel diz 20%, a conta do steal dá 0,4 cores, e o trabalho efetivamente realizado estabiliza em 0,41. A tabela mostra também que não houve pico antes do corte: a linha é plana por duas horas e cai de uma vez.
O steal durante o incidente é a assinatura do próprio limite, visto de dentro da VM, e não pista de uma causa externa. A Hostinger não mexeu em nada dentro do sistema operacional: ela parou de escalonar nossas vCPUs no hipervisor, e de dentro da máquina isso aparece como steal.
É a mesma armadilha do pico de 100%, pela segunda vez no mesmo incidente. Uma métrica que parece apontar para a causa está retratando o efeito.
Dois cuidados de leitura:
- A rampa entre ~11:23 e ~11:30 não indica início gradual. A query usa
rate(...[5m]), então um degrau instantâneo aparece espalhado ao longo dos 5 minutos seguintes. A forma do gráfico é artefato da janela e é compatível com um corte abrupto às 11:26:30. O steal estava plano até o momento do corte, então o gráfico não mostra contenção crescendo antes do evento. - Os 14,3% medidos em 08/10 foram colhidos com o limite já removido e ficam na mesma ordem de grandeza do ruído de fundo de antes do incidente. É contenção normal de host compartilhado, não anomalia.
Isso responde como o limite foi aplicado. Por que o algoritmo decidiu agir às 11:26:30 continua dependendo do suporte.
Por que isso virou 10h38 de indisponibilidade
Um provedor cortar CPU sem aviso é um risco de fornecedor. Dez horas e meia de jogadores sem conseguir entrar é consequência nossa, e é a parte acionável da causa raiz:
Por que os jogadores não conseguiam entrar? Porque a CPU da VPS estava limitada a 20% e os processos sofriam throttling contínuo.
Por que o limite foi aplicado? Porque o algoritmo do provedor decidiu aplicá-lo. Gatilho externo, critério desconhecido, fora do nosso controle.
Por que levamos 9h48 para perceber? Porque nada verificava a única pergunta que importa para o jogador: "consigo conectar?". Toda a nossa telemetria olha para dentro da VM e mede recursos (CPU, memória, disco), nunca a disponibilidade do serviço do ponto de vista de quem usa.
Por que o alerta que existia não resolveu? Porque ele disparou para um canal que recebia 47,8 notificações por dia e já não era lido por ninguém. O sinal estava certo e chegou na hora certa; o canal é que havia deixado de funcionar como canal (ver Por que não detectamos antes).
Por que estávamos expostos a um corte desses? Porque rodamos produção com ~40% de uso-base contínuo numa VPS compartilhada de 2 vCPUs, sem política de folga definida e sem saber de onde vem esse uso-base.
A parte controlável da causa raiz são três ausências:
- Nenhum sinal de disponibilidade voltado ao usuário. Só métricas de recurso, que respondem "a máquina está bem?" e não "o serviço está de pé?".
- Um canal de alerta saturado a ponto de não funcionar como canal.
- Nenhuma política de folga de capacidade num ambiente compartilhado, onde o provedor pode decidir por você sem avisar.
Nenhuma das três foi criada pelo corte da Hostinger. Ele só foi o primeiro evento a cobrar as três ao mesmo tempo.
Capacidade: de onde vêm os ~40%
A VPS rodava a ~37-40% de CPU havia meses, e ninguém tinha aberto esse número. Medindo a média das últimas 24h de um dia normal, numa VPS de 2 vCPUs:
| Componente | Cores | % das 2 vCPUs |
|---|---|---|
| Trabalho real do nó | 0,597 | 29,9% |
| CPU steal | 0,247 | 12,4% |
| Soma (é isso que o painel mostra) | 0,844 | 42,2% |
A fórmula que produz esse número é 100 − (idle ÷ total), e ela conta o steal como se fosse consumo. Mas steal é o oposto de consumo: é CPU que pedimos e o hipervisor não entregou.
O consumo real da ARCA é de ~30%. Os outros ~12 pontos percentuais são contenção do host compartilhado da Hostinger.
Os 42,2% que calculamos batem com os 37-40% que o painel deles exibe. Se o algoritmo de limitação se baseia nesse mesmo número, então a Hostinger limitou um cliente por um consumo que ela própria estava gerando. É hipótese, não conclusão: só o suporte pode confirmar sobre qual número o gatilho opera, e essa virou a pergunta prioritária.
Os 30% de trabalho real, destrinchados
| Camada | Cores | Fatia do trabalho real |
|---|---|---|
| Fora de pods (k3s, containerd, kubelet, sistema) | 0,348 | 58% |
| Soma de todos os pods | 0,249 | 42% |
E dentro dos pods:
| Namespace | Cores | % das 2 vCPUs |
|---|---|---|
argocd | 0,0898 | 4,5% |
traefik | 0,0631 | 3,2% |
kelbi-pg | 0,0310 | 1,6% |
apps | 0,0199 | 1,0% |
cloudflare-tunnel | 0,0147 | 0,7% |
monitoring | 0,0129 | 0,6% |
kube-system | 0,0074 | 0,4% |
velero | 0,0035 | 0,2% |
external-secrets | 0,0030 | 0,2% |
kelbi + erupe (servidores de jogo) | 0,0026 | 0,1% |
homepage | 0,0008 | 0,04% |
Os servidores de jogo, que são a razão de a VPS existir, consomem 0,4% do trabalho real da máquina. Os outros 99,6% são plataforma: o control plane do k3s sozinho pesa mais que o dobro de todos os pods somados, e o ArgoCD pesa 35 vezes mais que o jogo.
Isso inverte a decisão que estava na mesa. "Upgrade de plano vs. CPU dedicada" supunha que a carga vinha do produto e que era preciso comprar mais máquina. Os dados dizem que a carga é quase toda overhead de plataforma, e que existe caminho de redução antes de existir caminho de compra.
Um pico diário sem supervisão
O cronjob de backup do Postgres (kelbi-pg-backup-cronjob) consome 0,704 cores, 35% da VPS inteira, enquanto roda, durante cerca de 5 minutos por dia (0,35% do tempo). Somado ao uso-base, isso leva a máquina a picos perto de 65%.
Verificamos que ele não rodou na janela do incidente, então não é o gatilho de 06/10. Mas é o maior evento de CPU recorrente que temos, acontece todo dia sem acompanhamento, e é o candidato mais provável a disparar o algoritmo da Hostinger numa próxima vez.
Os números acima são a média de uma janela de 24h (07-08/10). A carga do jogo varia com o número de jogadores, então a fatia de kelbi/erupe pode ser maior em horário de pico. A conclusão de que a plataforma domina o consumo é robusta à variação; a proporção exata não é. Vale repetir a medição num fim de semana movimentado antes de decidir sobre o plano.
Por que não detectamos antes
O achado principal deste postmortem é fadiga de alerta (alert fatigue). Existe telemetria própria (o nosso Grafana, na seção de evidências) e existem alertas configurados: o canal #alerting do Discord vinha recebendo, em média, ~47,8 notificações por dia nos 30 dias anteriores ao incidente (confirmado via Alertmanager). O problema é que esses alertas viraram spam, foram normalizados, e ninguém mais prestava atenção neles. Quando o pico real de 11:26:00 aconteceu, levando o volume a 71 notificações em uma única hora, o alerta correspondente se perdeu no ruído de um canal que já operava, rotineiramente, perto do seu limite de saturação.
Alertmanager, volume de notificações por hora (sum(increase(alertmanager_notifications_total[1h]))). De uma baseline recorrente de poucas notificações/hora, o volume salta para 40-70 notificações/hora a partir de ~12:00 de 2026-10-06, com pico de 71,3 notificações em uma única hora (14:18), caindo a zero logo depois da remoção do limite (~22:00):
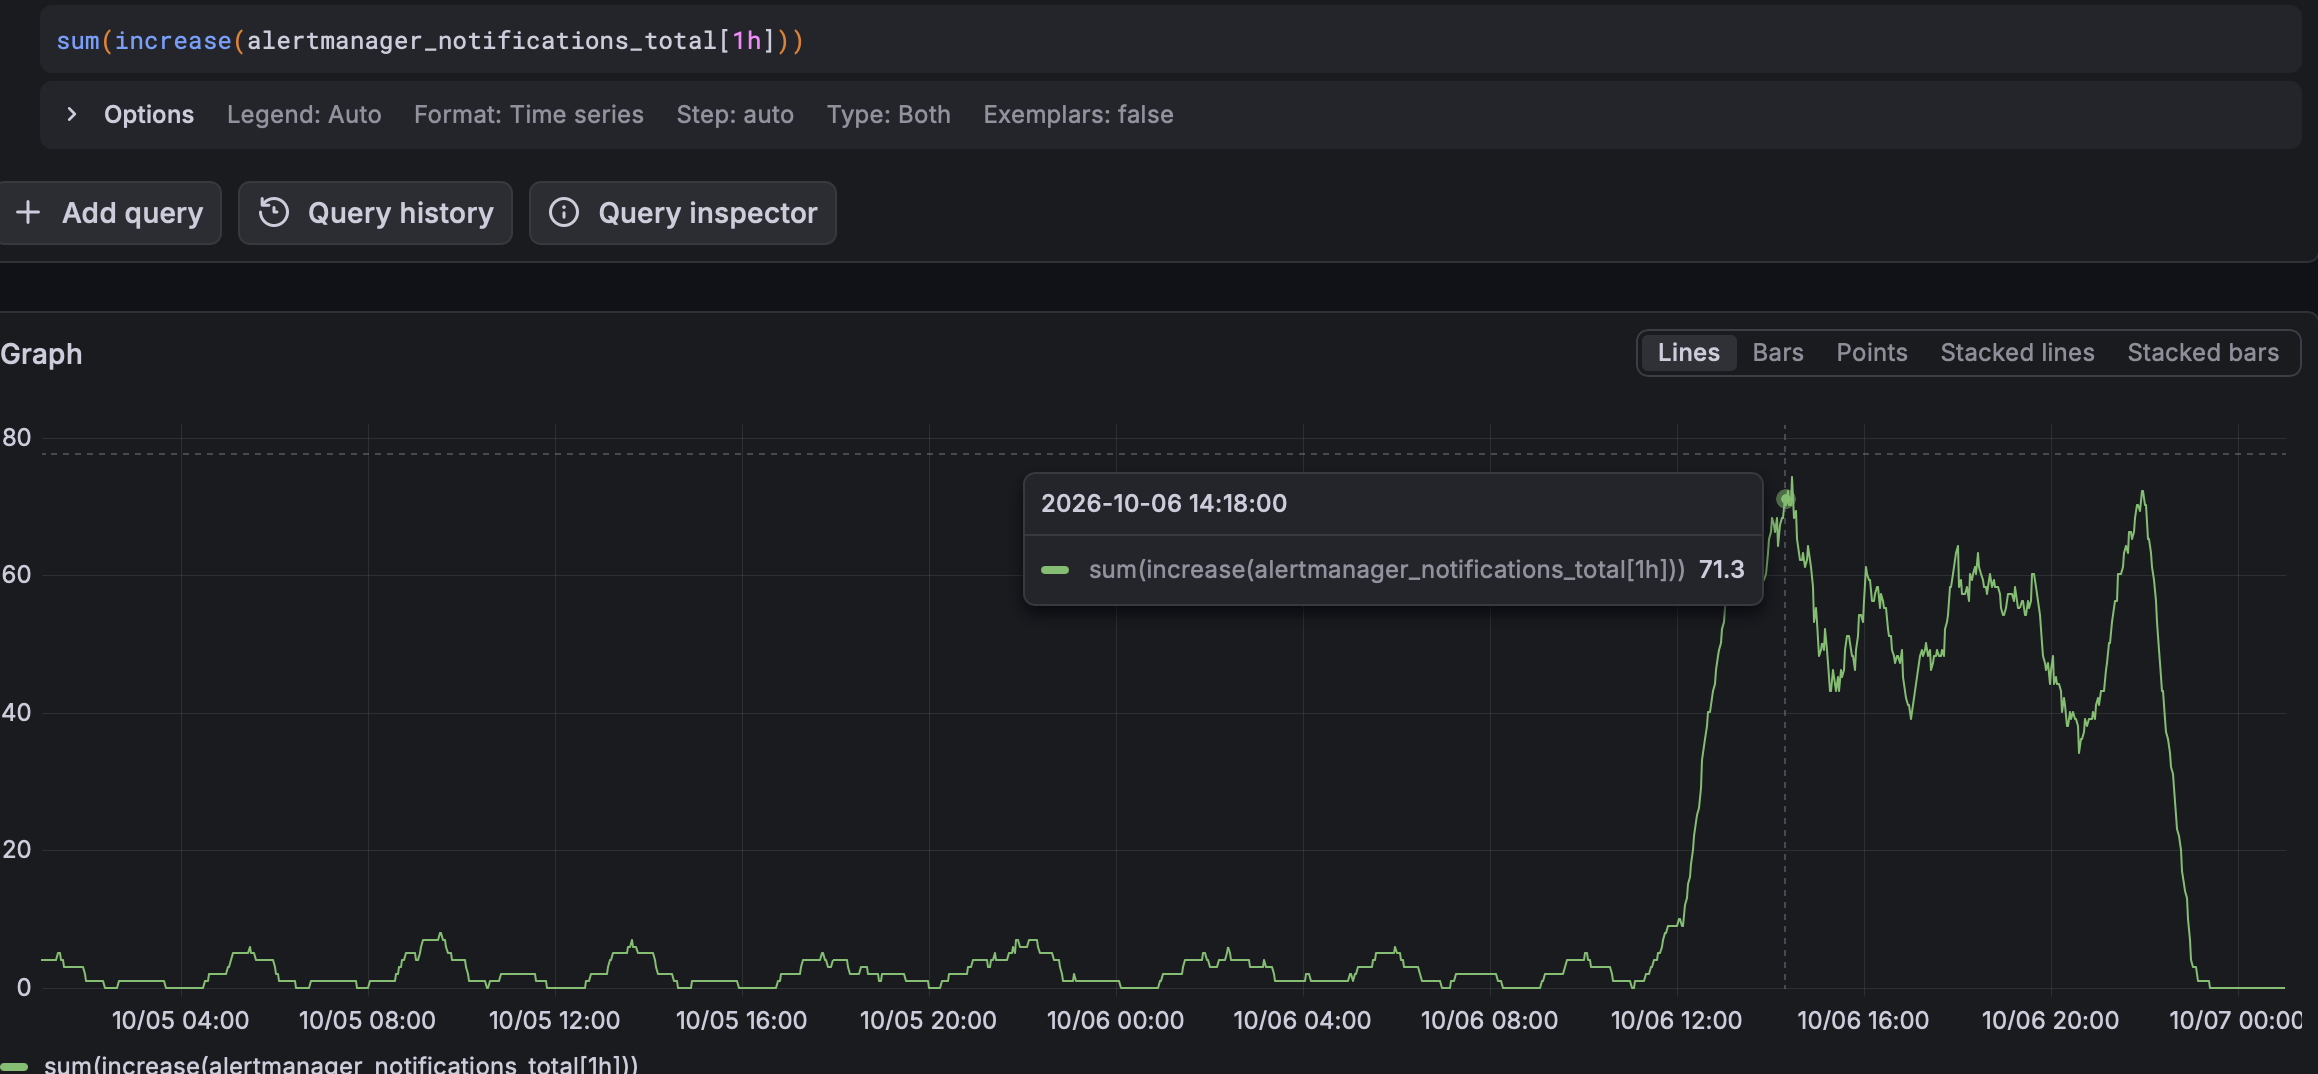
Esse gráfico cobre a janela de 2026-10-05 a 2026-10-07 e confirma o volume de spam durante o dia do incidente. A duração crônica do ruído de fundo está confirmada no gráfico de média móvel de 30 dias logo abaixo.
Alertmanager, média móvel de 30 dias (avg_over_time(sum(increase(alertmanager_notifications_total{integration="discord"}[1d]))[30d:1d])). Confirma que o #alerting não era um evento pontual: a média diária sobe de ~42 para ~48 notificações/dia ao longo de setembro e se mantém nessa faixa (46-49/dia) até a véspera do incidente, fechando em 47,8 notificações/dia na janela imediatamente anterior:
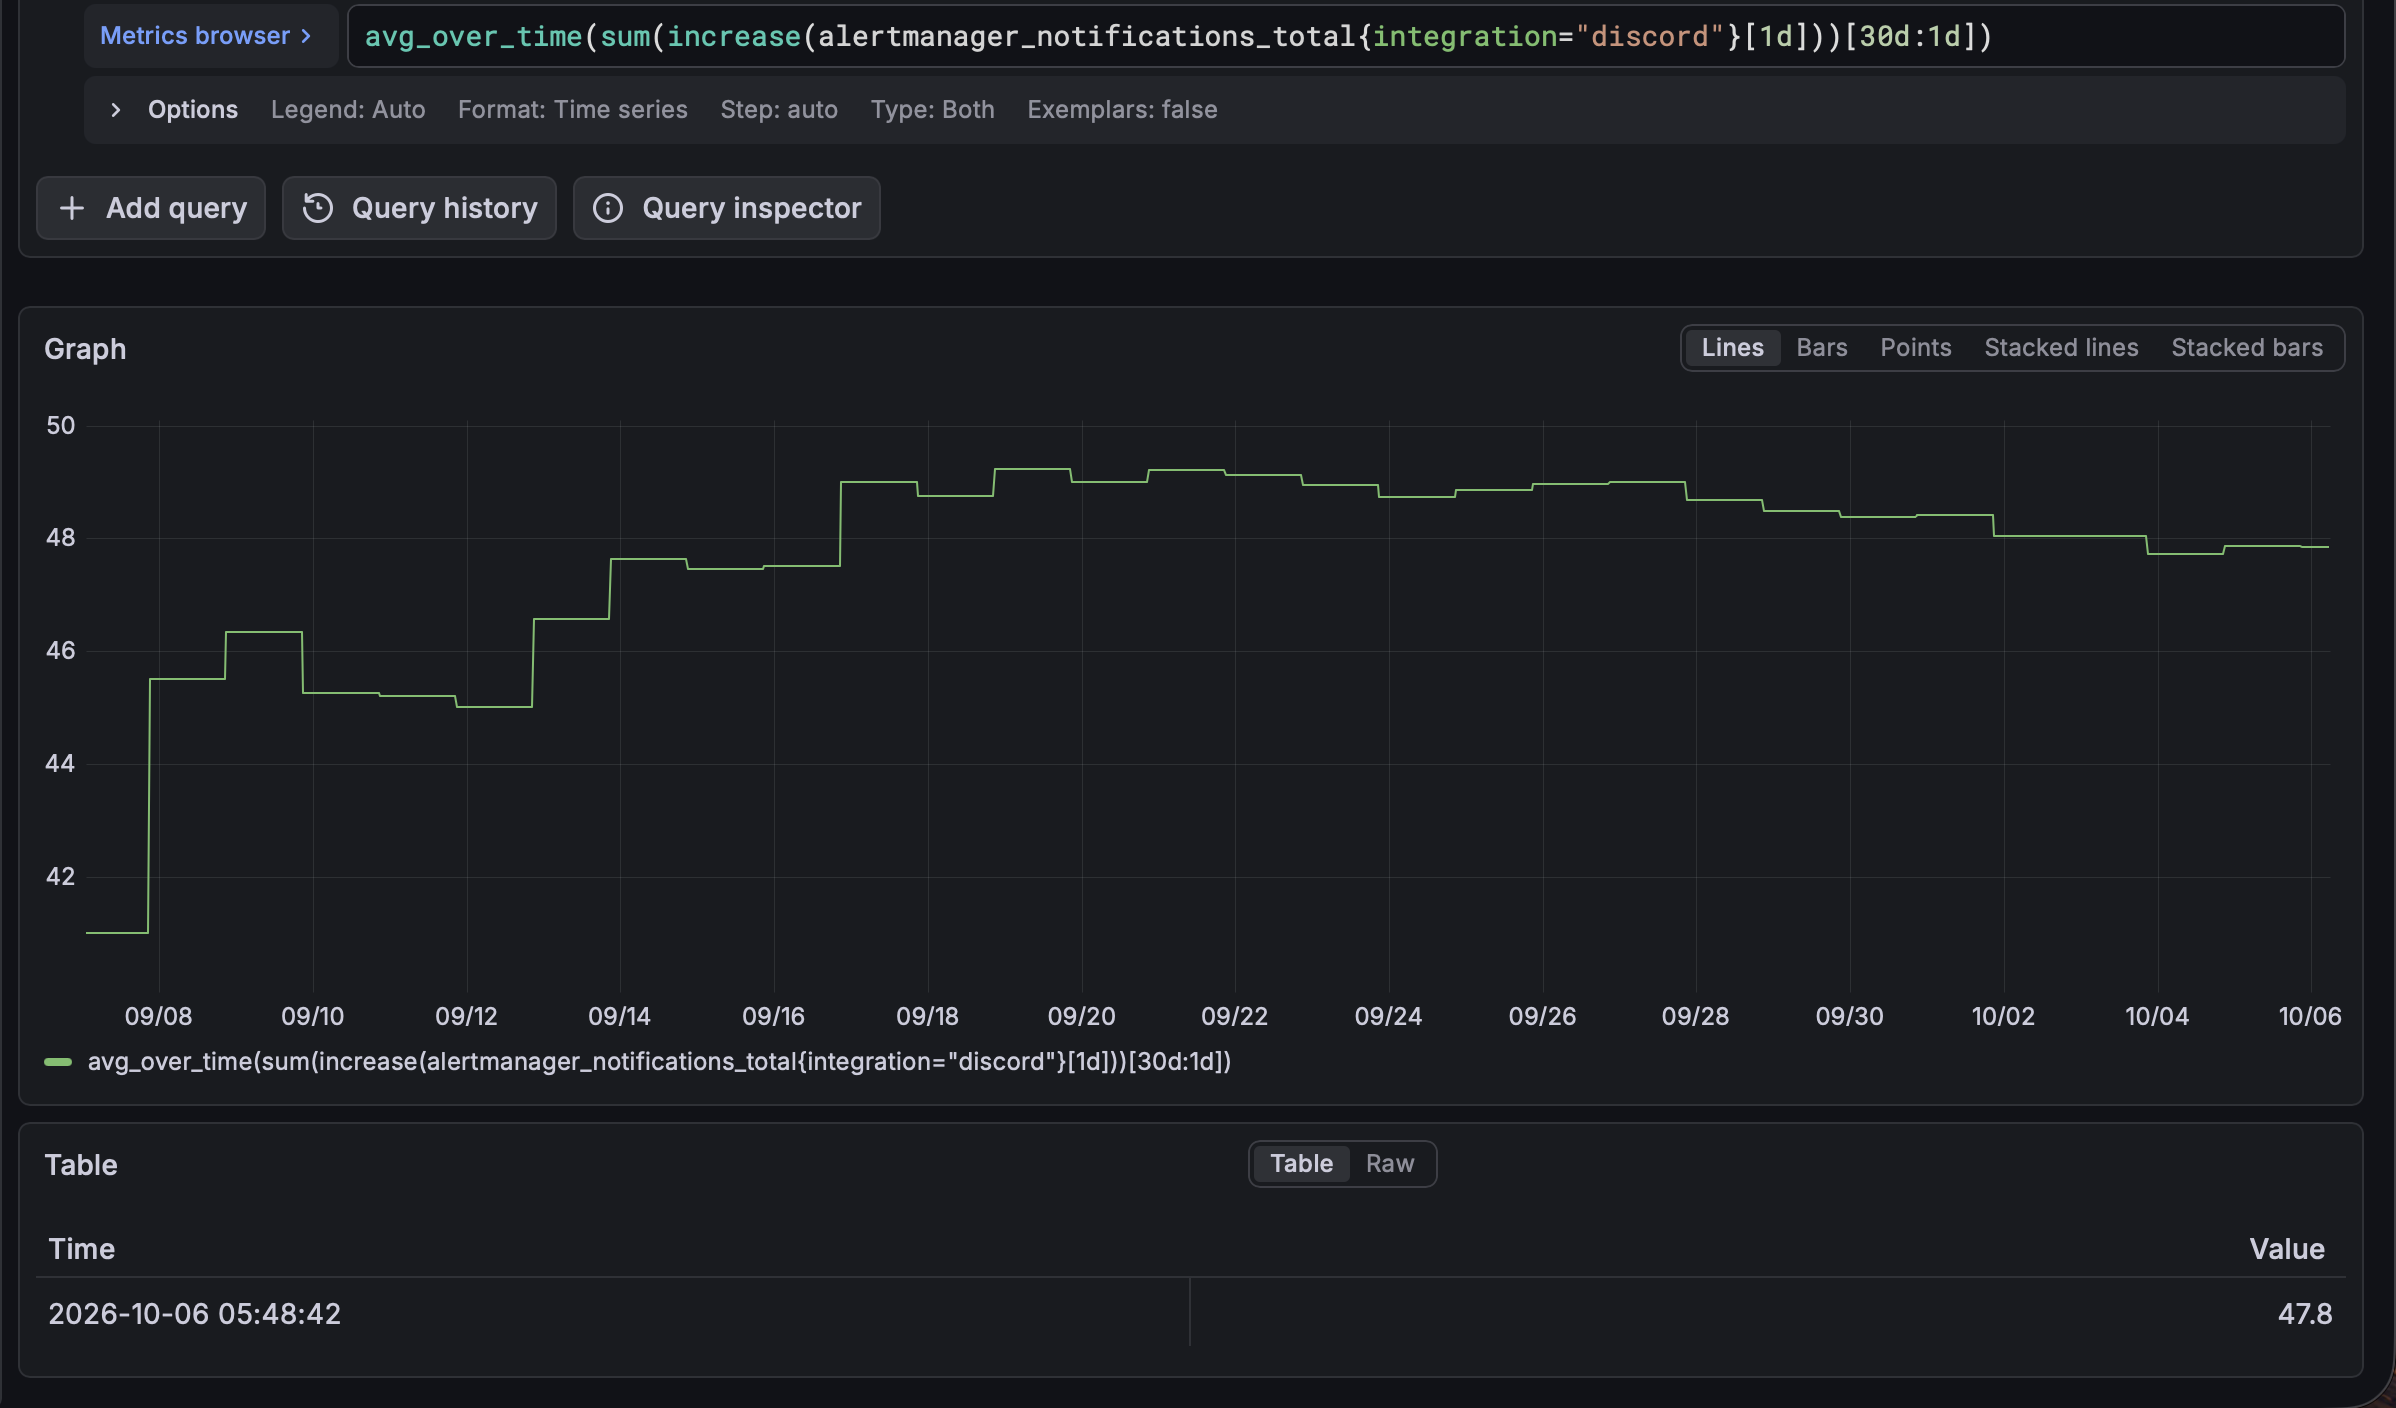
O sinal existia desde muito antes do corte da Hostinger, repetidamente, no canal certo, então não é um caso de falta de informação. A falha foi de processo e higiene de alerta, não de ausência de dado:
- Alertas de CPU no
#alertingficaram acumulando por meses sem triagem, silenciamento ou ajuste de limiar - Ninguém diferenciou "ruído recorrente conhecido" de "sinal de um problema real e crescente"
- A detecção efetiva do incidente dependeu de um canal totalmente diferente (jogadores reportando no Discord da comunidade), e não do canal de alerting que deveria ter pego isso primeiro
O encaminhamento desse achado está no RFC 0003 — Fadiga de alertas no #alerting, que propõe triagem inicial, dono com SLA de resposta, revisão periódica do volume e separação por severidade.
A telemetria granular por processo/pod (hostmetrics/kubeletstats, ver ADR 0001) também já estava instrumentada, e foi o que permitiu a evidência de CPU/memória por app usada em Impacto.
Como os alertas foram quantificados
A equipe usa Alertmanager, que expõe a métrica alertmanager_notifications_total (contador, por integration). A query usada para o volume por hora, visível na evidência acima:
sum(increase(alertmanager_notifications_total[1h]))
Para o total histórico (meses), a mesma lógica, filtrando pela integração do Discord e somando por dia em vez de hora (range queries muito longas de uma vez costumam estourar o limite do Prometheus):
sum(increase(alertmanager_notifications_total{integration="discord"}[1d]))
Dois cuidados ao interpretar o resultado:
integrationidentifica o tipo de integração, não o canal ou receiver específico. Se houver mais de um receiver usandodiscord_configs, a query soma todos juntos; vale checar os labels disponíveis sem filtro antes de confiar no número.- O contador zera em restart do Alertmanager. Se ele reiniciou em algum ponto do período investigado (deploy, crash, OOM),
increase()subconta a partir dali; checarprocess_start_time_seconds{job="alertmanager"}para identificar restarts na janela.
Contexto externo
Esse comportamento não é incomum entre usuários da Hostinger. Um relato semelhante foi encontrado no Reddit (r/Hostinger), de um usuário (u/arckhanum) que teve a VPS limitada duas vezes em dias próximos: uma vez por "75% de CPU por algumas horas" (com shutdown completo e perda de clientes), e depois por apenas "20% de CPU por algumas horas":
"What's most concerning is that these limitations are not clearly communicated at the time of purchase. Not even in the documentation provided by support staff is there any mention of CPU usage limits. [...] If the provider can arbitrarily limit my server and compromise my business without clear criteria, adequate documentation, or prior notice, it makes no sense to continue using this platform."
Pontos em comum com o nosso caso:
- Limite aplicado sem critério numérico claro ou consistente
- Sem aviso prévio antes da ação
- Documentação da Hostinger não detalha os limites de uso aceitável de CPU por plano
Contato com o suporte da Hostinger
Em 2026-10-08, enviamos um e-mail ao suporte da Hostinger relatando o incidente e cobrando esclarecimento sobre o critério/gatilho da limitação automática, a base de cálculo do limite de 20%, a ausência de notificação prévia e se esse comportamento está documentado em algum lugar. Aguardando retorno.
O que a investigação fechou
Perguntas que estavam abertas no começo da investigação, e o que respondeu cada uma:
- O que causou o pico de CPU às 11:26:00? A pergunta estava mal formulada: o dente de serra perto de 100% é o efeito do throttling, não um processo descontrolado. Não há culpado a caçar.
- Tínhamos telemetria própria do padrão de uso? Sim. O uso-base de ~37-40% está confirmado tanto pelo painel da Hostinger quanto pelo nosso Grafana.
- Houve CPU steal elevado durante o incidente? Sim, e o dado histórico já existia desde março. Mas o steal é o mecanismo do limite, não indício de vizinho ruidoso (ver Como o limite foi imposto).
- Quantas vCPUs tem a VPS? Duas, confirmado por três vias: o contrato, o painel e a cardinalidade de
system_cpu_time_seconds_total(16 séries = 2 CPUs × 8 estados). - O que era a série
-de 0,84 cores? Uma cópia duplicada do cluster inteiro, produzida pela falha de enriquecimento de metadados do OTel Collector sob inanição de CPU (ver A contagem dupla). - Afinal, 40% de quê? De nada que seja só nosso: ~30% é trabalho real e ~12% é CPU steal do host compartilhado. E dos 30%, o produto responde por 0,4%; o resto é plataforma (ver Capacidade).
- Qual era o volume de ruído no
#alerting? Média de 47,8 notificações/dia nos 30 dias anteriores, subindo de ~42/dia no início de setembro, e 40-70/hora durante o incidente, com pico de 71,3.
Uma pergunta continua sem resposta: por que o algoritmo da Hostinger agiu às 11:26:30, e não em qualquer outro dia dos últimos meses com o mesmo padrão de uso. Depende do suporte e está rastreada em Ações de acompanhamento.
Lições aprendidas
O que fomos bem
A telemetria estava pronta antes de ser necessária. O OTel Collector montado em março (ADR 0001) permitiu reconstruir o incidente minuto a minuto meses depois, inclusive o CPU steal, uma métrica que ninguém tinha em mente quando aquela coleta foi configurada.
A resposta foi rápida: trinta e oito minutos entre o primeiro relato e a mitigação, incluindo diagnosticar um comportamento do provedor que a equipe nunca tinha visto.
A comunidade foi atendida em quatro minutos. PS2slim reportou às 21:14 e Kushi respondeu "vou olhar" às 21:18.
A investigação derrubou as próprias hipóteses duas vezes. A conta de que 0,84 cores seriam 20% de ~4,2 cores caiu ao confirmar as 2 vCPUs reais; a hipótese de vizinho ruidoso caiu ao olhar o histórico de steal. Nos dois casos, o dado venceu a narrativa mais conveniente.
O que não fomos bem
Medíamos a máquina, não o serviço. Tínhamos CPU, memória, disco, rede, métricas por pod e por app, e nada que respondesse à única pergunta que o jogador faz: "consigo entrar?". Foi por isso que a detecção veio do Discord, 9h48 depois, em vez de vir do Grafana.
Alerta ignorado é pior que alerta ausente, porque um canal silencioso ao menos não cria ilusão de cobertura. O #alerting disparou na hora certa, com o conteúdo certo, e isso não produziu nenhuma ação durante dez horas.
Em VPS compartilhada, folga de capacidade é o que impede o provedor de decidir por você. Rodávamos a ~40% de uso-base contínuo havia meses sem que isso tivesse sido uma decisão consciente; virou uma no dia em que alguém do outro lado resolveu agir.
A mitigação dependeu de alguém saber onde clicar. Resolver o incidente exigia conhecer o botão "Remover limite" no painel da Hostinger e ter acesso a esse painel, e na época não estava registrado em lugar nenhum quem tinha esse acesso. Hoje está: Yslan Ramos e Ryuzaki (ver Mitigação). Continuam sendo duas pessoas, então a recuperação ainda depende de pelo menos uma delas estar disponível.
Não sabemos o tamanho do estrago. Dois jogadores reportaram, mas quantos tentaram entrar e desistiram ao longo das dez horas continua desconhecido, o que também impede comparar este incidente com qualquer outro no futuro.
A observabilidade degradou junto com o serviço. Sob inanição de CPU, o OTel Collector parou de enriquecer metadados e passou a emitir uma cópia duplicada e anônima de cada pod. O painel por app, que era a ferramenta certa para diagnosticar aquele momento, passou a mostrar como maior consumidor um item que não existia. O monitoramento disputa CPU com o sistema que monitora, então degrada junto com ele.
Repetimos "40% de CPU" por meses sem nunca perguntar 40% de quê. O número virou fato aceito e chegou a fundamentar uma decisão de infraestrutura sem que ninguém o tivesse aberto. Quando abrimos, um terço dele não era nosso, e o produto respondia por menos de 1% do resto.
Onde tivemos sorte
Um jogador resolveu falar. Nighty vinha tentando entrar desde as 20h e não reportou nada, achando que o problema era na própria máquina. A detecção dependeu de PS2slim decidir perguntar no Discord às 21:14. Sem esse voluntário, o limite poderia ter atravessado a noite inteira, ou mais.
O limite foi de 20%, e não um desligamento. O caso relatado no Reddit (Contexto externo) envolveu shutdown completo da VPS. Com 20% o serviço degradou, mas a máquina continuou de pé, e com ela o acesso ao painel, ao Grafana e à coleta de métricas. Se tivessem desligado a VPS, teríamos perdido também a telemetria do próprio período que precisávamos investigar.
O hostmetrics já coletava CPU steal, por acaso. O scraper cpu foi habilitado sem uma lista restrita de estados, então o steal veio junto. Numa configuração mais enxuta, a causa raiz teria parado em hipótese.
A remoção do limite era um botão. Não exigiu abrir ticket nem negociar com o suporte, o que teria custado horas ou dias. Nada garante que seja assim da próxima vez.
Ações de acompanhamento
Cada ação tem um tipo, que diz contra qual parte do incidente ela age. Detectar encurta os 9h48 até alguém perceber; Prevenir reduz a chance de o corte acontecer de novo; Mitigar encurta o tempo entre perceber e resolver; Processo corrige como trabalhamos.
Nenhuma ação tem responsável nem data definidos ainda; isso precisa ser acordado pela equipe. Ação de postmortem sem dono é ação que não acontece.
| Ação | Tipo | Dono | Prazo | Status |
|---|---|---|---|---|
Probe externo de disponibilidade: checagem TCP na porta do servidor de jogo, rodando de fora da VPS (o Prometheus + Alertmanager do Contabo já existem, ver ADR 0001), com alerta critical em canal separado do #alerting | Detectar | — | — | Pendente |
Painel e alerta de CPU steal sustentado. O dado já é coletado pelo hostmetrics desde março e foi o que explicou este incidente; falta transformá-lo em alerta | Detectar | — | — | Pendente |
Executar o RFC 0003: triagem do #alerting, dono de plantão e SLA de resposta | Processo | — | — | RFC escrita (Proposed, 2026-10-08); execução pendente |
| Prevenir | — | — | Concluída, ver Capacidade | |
Corrigir a recording rule do painel por app. Ela deriva namespace/app do label job e joga tudo que não casa num balde anônimo, em silêncio. Precisa cair para os labels nativos (k8s_namespace_name, k8s_pod_name) ou alertar quando o balde vazio aparecer | Detectar | — | — | Pendente |
| Investigar a falha de enriquecimento do OTel Collector sob pressão de CPU e garantir que o coletor tenha reserva suficiente para não degradar junto com o nó | Detectar | — | — | Pendente |
| Reduzir o overhead de plataforma antes de considerar upgrade: 58% do trabalho real é control plane do k3s e 0,09 cores são só do ArgoCD, contra 0,0026 do produto | Prevenir | — | — | Pendente |
| Acompanhar o cronjob de backup do Postgres, que consome 35% da VPS por ~5 min/dia sem nenhuma supervisão e é o candidato mais provável a disparar a próxima limitação | Prevenir | — | — | Pendente |
| Definir política de folga de capacidade (ex.: manter o uso-base abaixo de 50% do contratado), com alerta de aviso antes de chegar no limite | Prevenir | — | — | Pendente |
| Mitigar | — | — | Concluída: Yslan Ramos e Ryuzaki, ver Mitigação | |
| Avaliar se o plano de VPS atual é adequado à carga-base de ~37-40% (upgrade vs. CPU dedicada). Depende da quebra do uso-base acima | Prevenir | — | — | Pendente |
| Avaliar alternativas de provedor, dado o padrão relatado por outros usuários Hostinger | Prevenir | — | — | Pendente |
| Quantificar os jogadores afetados a partir dos logs do servidor de jogo ou do Postgres, e adotar essa métrica como medida de impacto padrão | Processo | — | — | Pendente |
| Definir uma escala de severidade para postmortems, para que incidentes sejam comparáveis entre si | Processo | — | — | Pendente |
| Confirmar com o suporte da Hostinger o critério/gatilho exato que fez a limitação disparar às 11:26:30, e agora prioritariamente se o número que o algoritmo avalia inclui CPU steal. Se incluir, a Hostinger limitou a VPS por consumo gerado pelo próprio host dela | Externo | — | — | Aguardando retorno (e-mail enviado em 2026-10-08); pergunta sobre steal ainda a enviar |